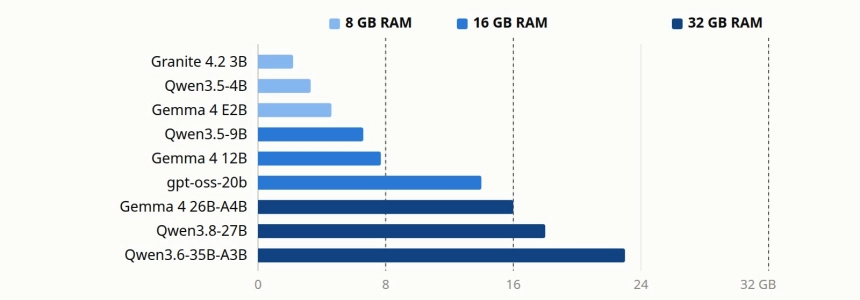
Para usar un modelo de lenguaje decente en tu propio ordenador ya no hace falta tarjeta gráfica. La respuesta corta, a noviembre de 2026: con 8 GB de RAM, instala Qwen3.5-4B; con 16 GB, Qwen3.5-9B o Gemma 4 12B; con 32 GB, un modelo de mezcla de expertos como Qwen3.6-35B-A3B o Gemma 4 26B-A4B, que en un procesador van mucho más rápido de lo que su tamaño hace pensar.
No hemos medido estos modelos nosotros. Esta guía reúne lo que publican los fabricantes, las clasificaciones independientes y las pocas mediciones de terceros en procesadores normales, y dice en cada caso de dónde sale el dato. Los nombres, tamaños y etiquetas de descarga se comprobaron el 18 y el 19 de noviembre de 2026.
Cómo saber si un modelo cabe en tu RAM
Los modelos locales se descargan normalmente como archivos GGUF, comprimidos («cuantizados») a menos bits por peso. El formato más habitual, Q4_K_M, usa unos 4,9 bits por peso, así que el archivo pesa más o menos el número de parámetros × 4,9 ÷ 8. Para un modelo de 9.000 millones de parámetros salen unos 5,5 GB, y el archivo real de Qwen3.5-9B pesa 5,63 GB.
Después hay que sumar dos cosas:
- El propio programa, que ocupa entre 0,3 y 0,6 GB además del modelo, según mediciones con llama.cpp.
- El contexto, es decir, la memoria donde el modelo guarda la conversación (la caché KV). Crece con cada token: en Qwen3.5-4B y 9B, una conversación de 32.000 tokens añade alrededor de 1 GB.
Una regla sensata, sacada de una guía de vdf.ai de noviembre de 2026: el archivo del modelo no debería pasar del 60 % de la RAM en equipos de 8 y 16 GB (unos 4,8 y 9,6 GB) ni del 75 % en uno de 32 GB (unos 24 GB). El sistema operativo, el navegador y la gráfica integrada comparten la misma memoria.
Hay una trampa en la que cae casi todo el mundo: los modelos de mezcla de expertos (MoE) ocupan según sus parámetros totales, no según los activos. Qwen3.6-35B-A3B solo usa 3.000 millones de parámetros por token, pero los 35.000 millones tienen que estar en la RAM, porque el token siguiente puede necesitar cualquiera de los expertos.
Por qué la velocidad depende de la memoria y no de los núcleos
Para generar cada token, el procesador tiene que leer de la RAM todos los pesos activos. Por eso la velocidad depende sobre todo del ancho de banda de la memoria. Un modelo denso de 27.000 millones de parámetros lee entre 16 y 18 GB por token en Q4; un MoE con 3.000 millones activos lee unos 2 GB.
En la práctica la diferencia es enorme. En un servidor virtual con un Ryzen 9 de 16 núcleos, 32 GB y Ollama, arct.cloud midió 15,7 tokens por segundo con Qwen3.6-35B-A3B y solo 2,4 con el denso Qwen3.5-27B: el MoE fue seis veces más rápido. En la misma máquina, Qwen3.5-4B dio 13,4 tokens por segundo y Qwen3.5-9B, 7,8. Un servidor virtual tiene más ancho de banda que un portátil normal, así que toma estas cifras como un techo.
Para PC normales solo hay estimaciones. Estas son las de vdf.ai, que la propia fuente presenta como techos teóricos, no como mediciones:
| Memoria (doble canal) | Qwen3.5-4B | Qwen3.5-9B | gpt-oss-20b (MoE) | Denso de 27B |
|---|---|---|---|---|
| DDR4-3200 | ≈11 tok/s | ≈5 | ≈9 | ≈2 |
| DDR5-5600 | ≈20 | ≈10 | ≈15 | ≈3 |
| LPDDR5x-8533 | ≈30 | ≈15 | ≈23 | ≈4 |
Dos consecuencias prácticas. Con un solo módulo de RAM en lugar de dos, la velocidad cae a la mitad, así que el doble canal importa más que el número de núcleos. Y la gráfica integrada ayuda sobre todo a leer el prompt, no a escribir: Google midió Gemma 4 E2B en un portátil con Intel Lunar Lake leyendo 435 tokens por segundo en la CPU y 3.751 en la gráfica integrada, pero generando 29,8 y 48,4 respectivamente. Para los agentes de programación, que mandan ficheros enteros, esa lectura más rápida vale mucho.
Qué instalar con 8, 16 y 32 GB
Los tamaños son las descargas que indica la biblioteca de Ollama el 19 de noviembre de 2026; en los modelos multimodales incluyen el componente de visión.
| RAM | Uso | Modelo | Descarga | Etiqueta de Ollama |
|---|---|---|---|---|
| 8 GB | Uso general | Qwen3.5-4B | 3,3 GB | qwen3.5:4b |
| 8 GB | Con entrada de audio | Gemma 4 E2B | 4,6 GB | gemma4:e2b |
| 8 GB | Solo texto, probado en español e italiano | Granite 4.2 3B | 2,2 GB | granite4.2:3b |
| 8 GB | Autocompletar código | Qwen2.5-Coder 1.5B | 1 GB | qwen2.5-coder:1.5b |
| 8 GB | Leer documentos (OCR) | GLM-OCR | 2,7 GB | glm-ocr |
| 16 GB | Uso general y razonamiento | Qwen3.5-9B | 6,6 GB | qwen3.5:9b |
| 16 GB | Imágenes y audio | Gemma 4 12B | 7,7 GB | gemma4:12b |
| 16 GB | Razonamiento rápido (muy justo) | gpt-oss-20b | 14 GB | gpt-oss:20b |
| 16 GB | Autocompletar código | Qwen2.5-Coder 7B | 4,7 GB | qwen2.5-coder:7b |
| 32 GB | Uso general, código y razonamiento | Qwen3.6-35B-A3B | 23 GB | qwen3.6:35b |
| 32 GB | Más memoria libre | Gemma 4 26B-A4B | 16 GB | gemma4:26b |
| 32 GB | Autocompletar código | Qwen3-Coder-30B-A3B | 19 GB | qwen3-coder:30b |
| 32 GB | Máxima calidad, si puedes esperar | Qwen3.8-27B | 18 GB | qwen3.8:27b |
Los modelos, uno a uno
Qwen3.5-4B y Qwen3.5-9B
Alibaba publicó los Qwen3.5 pequeños a principios de 2026 con licencia Apache 2.0. Aceptan imágenes, llaman a herramientas, tienen un contexto de 262.000 tokens y un modo de razonamiento que se puede encender y apagar. En marzo, Artificial Analysis los situó como los modelos más inteligentes por debajo de 5.000 y de 10.000 millones de parámetros (27 y 32 puntos en su índice de entonces).
El mismo análisis midió también su punto débil: en su prueba de conocimientos alucinaron el 80 % (4B) y el 82 % (9B) de las veces. Úsalos para redactar, resumir, traducir o trabajar sobre un documento que les des, no como enciclopedia. Y apaga el razonamiento para conversar: hay usuarios que ven al 4B pensando un buen rato incluso antes de contestar a un «hola».
Gemma 4: E2B, E4B, 12B y 26B-A4B
Google publicó Gemma 4 en abril de 2026, y por primera vez con licencia Apache 2.0 (hasta Gemma 3 usaba sus propios términos). Los nombres de los pequeños engañan: la «E» significa parámetros efectivos, y con sus tablas de embeddings los archivos contienen 5.100 y 8.000 millones de parámetros. En Ollama pesan 4,6 y 6,6 GB.
Su punto fuerte es el audio: E2B, E4B y 12B aceptan clips de voz de hasta 30 segundos, algo que no ofrece ningún otro modelo pequeño de un gran laboratorio. En calidad bruta quedan por detrás de Qwen a igual tamaño. Gemma 4 12B, publicado el 3 de junio de 2026, trabaja con imágenes, audio y vídeo sin codificador aparte y es la alternativa a Qwen3.5-9B en 16 GB; ya escribimos sobre cómo construir aplicaciones multimodales con él. Gemma 4 26B-A4B es un MoE con 3.800 millones de parámetros activos que, en la comparativa de abril de Artificial Analysis, gastó menos tokens que sus rivales para resultados parecidos.
gpt-oss-20b
El modelo abierto de OpenAI es de agosto de 2025 y sigue en todas las listas porque no tiene sucesor. Es un MoE de 21.000 millones de parámetros con 3.600 millones activos, Apache 2.0, que ocupa 14 GB en Ollama. Permite elegir el esfuerzo de razonamiento (bajo, medio o alto) y se maneja bien con herramientas, pero solo acepta texto y necesita su propio formato de conversación, llamado harmony. En 16 GB solo cabe si cierras casi todo lo demás. En razonamiento se ha quedado atrás: sus propias cifras en la prueba científica GPQA (entre 59 y 67, según el esfuerzo) están por debajo del 81,7 que Qwen publica para Qwen3.5-9B.
Qwen3.6-35B-A3B
Si tienes 32 GB, es el primer modelo que hay que probar. Publicado en abril de 2026 con licencia Apache 2.0, tiene 35.000 millones de parámetros pero solo 3.000 millones activos, acepta imágenes y es el que dio 15,7 tokens por segundo en la medición en CPU de antes, con un pico de 22,9 GiB (unos 24,6 GB) a 8.000 tokens de contexto. Va muy justo: cierra el navegador antes de cargarlo. Qwen publica un 73,4 en SWE-bench Verified, una prueba que consiste en arreglar errores reales de proyectos de software; con otro arnés de pruebas, Krafton midió un 63,2. Los benchmarks dependen mucho de quién los pase.
Granite 4.2 3B y 8B
Granite 4.2 de IBM (25 de agosto de 2026, Apache 2.0, pesos firmados criptográficamente) solo trabaja con texto, pero es la única familia de esta lista que nombra expresamente el español y el italiano entre los idiomas en los que se evaluó. Tiene tres modos: con razonamiento, sin él o con poco esfuerzo. Para un asistente de texto en esos idiomas merece una prueba junto a Qwen.
Los densos de 27 a 31B: caben, pero no corren
Qwen3.8-27B (agosto de 2026), Gemma 4 31B y Muse Glimmer 30B de Meta (agosto de 2026, Apache 2.0 más una política de uso, el primer modelo abierto de Meta desde Llama 4) son los más capaces de los que caben en 32 GB: sus archivos Q4 pesan entre 17 y 20 GB. Qwen3.8-27B publica las mejores notas del grupo, como un 89,2 en GPQA Diamond, y por defecto razona con el máximo esfuerzo.
El problema es la velocidad. Al ser densos, en un PC sin tarjeta gráfica van a entre 2 y 4 tokens por segundo según las estimaciones, y el único denso de 27B medido dio 2,4. Con el razonamiento encendido, una sola respuesta puede tardar muchos minutos. Tienen sentido en un Mac con memoria unificada (Meta da 23,7 tokens por segundo para Muse Glimmer en un M4 Max) o para dejar una pregunta difícil en marcha y volver más tarde.
Programar: autocompletar y agentes piden modelos distintos
El autocompletado en el editor (FIM, fill-in-the-middle) necesita un modelo pequeño, sin razonamiento y entrenado para rellenar huecos. Para eso, la documentación de Continue sigue recomendando Qwen2.5-Coder 1.5B y 7B, y avisa de que los modelos de chat, aunque sean más grandes, suelen hacerlo mal. Con 32 GB, Qwen3-Coder-30B-A3B admite FIM y no tiene modo de razonamiento.
Los agentes como Cline, OpenCode o Continue en modo agente necesitan lo contrario: razonamiento y llamadas a herramientas fiables. Las opciones prácticas son Qwen3.5-9B con 16 GB y Qwen3.6-35B-A3B con 32 GB. Devstral Small 2 de Mistral (68,0 en SWE-bench Verified, según Mistral) está pensado para estas herramientas, pero es un denso de 24B y va lento sin tarjeta gráfica.
Todas estas notas de programación son de los fabricantes, y la única tabla independiente que solíamos consultar, la de Aider, no se actualiza desde noviembre de 2025. Compara modelos dentro de una misma tabla, nunca entre fichas distintas.
Razonamiento: el coste oculto en una CPU
Los modelos que razonan escriben lo que piensan antes de responder, y eso cuesta tiempo. Qwen recomienda reservar 32.768 tokens de salida para la mayoría de preguntas y 81.920 para matemáticas o programación difíciles. A 10 tokens por segundo, que es lo que da Qwen3.5-9B con DDR5 según las estimaciones, 3.000 tokens de razonamiento tardan unos cinco minutos, y el presupuesto completo de 32.768, casi una hora.
La buena noticia es que un razonamiento potente ya cabe en 16 GB: Qwen publica un 92,5 en AIME 2026 y un 81,7 en GPQA Diamond para Qwen3.5-9B. El consejo práctico: para trabajar en directo, un MoE con 3.000 o 4.000 millones de parámetros activos y el razonamiento en bajo o apagado; el esfuerzo alto, solo para preguntas que puedes dejar en marcha.
Imágenes y OCR
La única comparación independiente de modelos de visión pequeños que hemos encontrado es una prueba con 30 imágenes publicada en r/LocalLLaMA en junio de 2026. Qwen3.5-4B sacó un 75,5 y fue el que más rindió por gigabyte; Qwen3.6-35B-A3B llegó a 76,4 y Qwen3.6-27B a 79,6, el mejor de todos. Dejó además tres consejos: el razonamiento empeora la visión (todos los Qwen puntuaron más con él apagado), Gemma 4 necesita más tokens por imagen de los que trae por defecto para leer letra pequeña, y la cuantización más alta no siempre gana.
En una CPU, lo lento es codificar la imagen, no escribir la respuesta: cuenta con decenas de segundos por captura. En un procesador de AMD, pasar el codificador de imágenes de la CPU a la gráfica integrada bajó ese tiempo de 39,8 a 10 segundos.
Para leer documentos en cantidad es mejor un especialista pequeño. El equipo de llama.cpp documenta el soporte de modelos de OCR como GLM-OCR, DeepSeek-OCR, dots.ocr y PaddleOCR-VL, y se arrancan con un solo comando:
llama-server -hf ggml-org/GLM-OCR-GGUFSi quieres usar Qwen con imágenes, hazlo con llama.cpp o LM Studio: las fuentes no se ponen de acuerdo sobre si la visión de Qwen3.5 y 3.6 funciona en Ollama.
Licencias: casi todo es libre, con excepciones
Prácticamente todos los modelos de esta guía son Apache 2.0 o MIT, así que se pueden usar con fines comerciales: Qwen3.5, Qwen3.6, Qwen3.8-27B, Gemma 4, gpt-oss, Granite 4.2 y los Ministral. Muse Glimmer añade una política de uso que excluye a los menores de 18 años. Las excepciones que conviene conocer:
- Liquid AI (LFM2.5, LFM3): su LFM Open License solo permite el uso comercial gratuito a empresas que facturen menos de 10 millones de dólares al año.
- EXAONE 4.5 de LG: licencia no comercial.
- HunyuanOCR de Tencent: su licencia no vale en la Unión Europea, el Reino Unido ni Corea del Sur.
- Los Qwen más grandes de Alibaba son cerrados o llevan licencias con condiciones de facturación, pero los tamaños de esta guía son Apache 2.0.
Qué programa usar
- LM Studio: la interfaz gráfica más cómoda en Windows y Mac. Es de código cerrado, pero gratis también para el trabajo desde julio de 2025.
- Jan: la alternativa de código abierto (MIT) con interfaz gráfica.
- llama.cpp: el motor que hay debajo de casi todo. Llegó a la versión 1.0 el 13 de noviembre de 2026, con una API estable y soporte para más de 150 arquitecturas de modelos. Los modelos nuevos llegan aquí antes que a ningún sitio, y
llama-serverincluye un chat web. - Ollama: el más fácil de integrar con otras aplicaciones y el que tiene más etiquetas listas para usar. En 2026 recibió muchas críticas por haber ocultado durante mucho tiempo que estaba construido sobre llama.cpp y por una aplicación de escritorio de código cerrado.
Con Ollama hay que vigilar dos cosas. Primero, escribe siempre el tamaño: ollama run qwen3.5 descarga el 9B (6,6 GB) y gemma4 el E4B (6,6 GB), demasiado para un equipo de 8 GB. Segundo, sin tarjeta gráfica limita el contexto a 4.000 tokens, así que los documentos largos se cortan sin avisar; se puede subir con el parámetro num_ctx, sabiendo que gasta más RAM.
ollama run qwen3.5:4b
llama-server -hf unsloth/Qwen3.5-4B-GGUF:Q4_K_M
Dos que puedes olvidar: GPT4All no publica versión desde febrero de 2025, e Intel archivó IPEX-LLM en enero de 2026.
Descarga solo de fuentes de confianza
Un archivo de modelo no son solo datos. En abril de 2026, el CVE-2026-5760 (gravedad 9,8 sobre 10) demostró que el servidor SGLang podía ejecutar código escondido en la plantilla de chat de un modelo. Entre los archivos de moda en Hugging Face abundan además copias modificadas «sin censura» de modelos populares. Descarga de la biblioteca oficial de tu programa o de cuantizadores conocidos: ggml-org, unsloth, bartowski y lmstudio-community.
Lo que todavía no ha medido nadie
No hay ninguna prueba publicada en CPU de los MoE de 32 GB en un procesador de sobremesa concreto, ni ninguna comparativa de 2026 de estos modelos en español o en italiano. Las cifras de los fabricantes (Qwen dice 201 idiomas; Gemma 4, más de 35 listos para usar) dicen poco de cómo escriben en tu idioma. Antes de elegir, prueba dos o tres candidatos con tus propios textos: con los comandos de arriba, es cosa de una tarde.
Y si además quieres que tu ordenador hable, lee nuestras pruebas de motores de texto a voz gratis que se instalan en local.