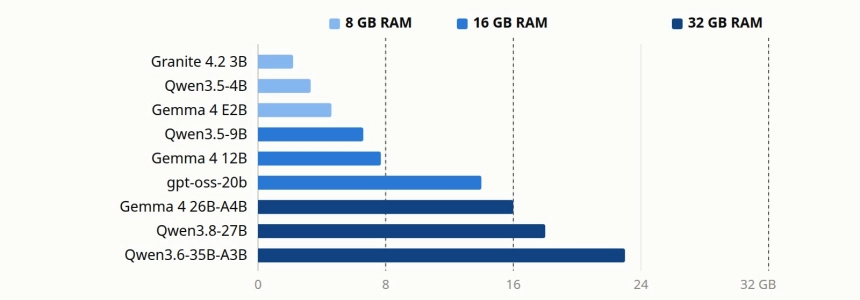
Per usare un modello linguistico decente sul tuo computer non serve più una scheda grafica. La risposta breve, a novembre 2026: con 8 GB di RAM, installa Qwen3.5-4B; con 16 GB, Qwen3.5-9B o Gemma 4 12B; con 32 GB, un modello a miscela di esperti come Qwen3.6-35B-A3B o Gemma 4 26B-A4B, che su un processore vanno molto più veloci di quanto faccia pensare la loro dimensione.
Non abbiamo misurato questi modelli noi. Questa guida mette insieme quello che pubblicano i produttori, le classifiche indipendenti e le poche misurazioni di terzi su processori normali, e per ogni dato dice da dove arriva. Nomi, dimensioni ed etichette di download sono stati verificati il 18 e il 19 novembre 2026.
Come capire se un modello entra nella tua RAM
I modelli locali si scaricano di solito come file GGUF, compressi («quantizzati») a meno bit per peso. Il formato più comune, Q4_K_M, usa circa 4,9 bit per peso, quindi il file pesa più o meno il numero di parametri × 4,9 ÷ 8. Per un modello da 9 miliardi di parametri vengono circa 5,5 GB, e il file reale di Qwen3.5-9B pesa 5,63 GB.
Poi bisogna aggiungere due cose:
- Il programma stesso, che occupa tra 0,3 e 0,6 GB oltre al modello, secondo misurazioni con llama.cpp.
- Il contesto, cioè la memoria in cui il modello tiene la conversazione (la cache KV). Cresce a ogni token: in Qwen3.5-4B e 9B, una conversazione di 32.000 token aggiunge circa 1 GB.
Una regola sensata, presa da una guida di vdf.ai di novembre 2026: il file del modello non dovrebbe superare il 60% della RAM sui computer da 8 e 16 GB (circa 4,8 e 9,6 GB) né il 75% su uno da 32 GB (circa 24 GB). Sistema operativo, browser e grafica integrata condividono la stessa memoria.
C’è una trappola in cui cadono quasi tutti: i modelli a miscela di esperti (MoE) occupano spazio in base ai parametri totali, non a quelli attivi. Qwen3.6-35B-A3B usa solo 3 miliardi di parametri per token, ma tutti i 35 miliardi devono stare in RAM, perché il token successivo può aver bisogno di uno qualsiasi degli esperti.
Perché la velocità dipende dalla memoria e non dai core
Per generare ogni token, il processore deve leggere dalla RAM tutti i pesi attivi. Per questo la velocità dipende soprattutto dalla larghezza di banda della memoria. Un modello denso da 27 miliardi di parametri legge tra 16 e 18 GB per token in Q4; un MoE con 3 miliardi attivi ne legge circa 2.
In pratica la differenza è enorme. Su un server virtuale con un Ryzen 9 a 16 core, 32 GB e Ollama, arct.cloud ha misurato 15,7 token al secondo con Qwen3.6-35B-A3B e appena 2,4 con il denso Qwen3.5-27B: il MoE è stato sei volte più veloce. Sulla stessa macchina, Qwen3.5-4B ha fatto 13,4 token al secondo e Qwen3.5-9B 7,8. Un server virtuale ha più banda di un portatile normale, quindi prendi queste cifre come un tetto.
Per i PC normali ci sono solo stime. Queste sono quelle di vdf.ai, che la fonte stessa presenta come tetti teorici, non come misurazioni:
| Memoria (doppio canale) | Qwen3.5-4B | Qwen3.5-9B | gpt-oss-20b (MoE) | Denso da 27B |
|---|---|---|---|---|
| DDR4-3200 | ≈11 tok/s | ≈5 | ≈9 | ≈2 |
| DDR5-5600 | ≈20 | ≈10 | ≈15 | ≈3 |
| LPDDR5x-8533 | ≈30 | ≈15 | ≈23 | ≈4 |
Due conseguenze pratiche. Con un solo modulo di RAM invece di due, la velocità si dimezza, quindi il doppio canale conta più del numero di core. E la grafica integrata aiuta soprattutto a leggere il prompt, non a scrivere: Google ha misurato Gemma 4 E2B su un portatile Intel Lunar Lake leggendo 435 token al secondo sulla CPU e 3.751 sulla grafica integrata, ma generando rispettivamente 29,8 e 48,4. Per gli agenti di programmazione, che inviano file interi, questa lettura più rapida vale molto.
Cosa installare con 8, 16 e 32 GB
Le dimensioni sono i download indicati dalla libreria di Ollama il 19 novembre 2026; nei modelli multimodali includono il componente per la visione.
| RAM | Uso | Modello | Download | Etichetta Ollama |
|---|---|---|---|---|
| 8 GB | Uso generale | Qwen3.5-4B | 3,3 GB | qwen3.5:4b |
| 8 GB | Con input audio | Gemma 4 E2B | 4,6 GB | gemma4:e2b |
| 8 GB | Solo testo, provato in italiano e spagnolo | Granite 4.2 3B | 2,2 GB | granite4.2:3b |
| 8 GB | Completamento del codice | Qwen2.5-Coder 1.5B | 1 GB | qwen2.5-coder:1.5b |
| 8 GB | Leggere documenti (OCR) | GLM-OCR | 2,7 GB | glm-ocr |
| 16 GB | Uso generale e ragionamento | Qwen3.5-9B | 6,6 GB | qwen3.5:9b |
| 16 GB | Immagini e audio | Gemma 4 12B | 7,7 GB | gemma4:12b |
| 16 GB | Ragionamento veloce (al limite) | gpt-oss-20b | 14 GB | gpt-oss:20b |
| 16 GB | Completamento del codice | Qwen2.5-Coder 7B | 4,7 GB | qwen2.5-coder:7b |
| 32 GB | Uso generale, codice e ragionamento | Qwen3.6-35B-A3B | 23 GB | qwen3.6:35b |
| 32 GB | Più memoria libera | Gemma 4 26B-A4B | 16 GB | gemma4:26b |
| 32 GB | Completamento del codice | Qwen3-Coder-30B-A3B | 19 GB | qwen3-coder:30b |
| 32 GB | Massima qualità, se puoi aspettare | Qwen3.8-27B | 18 GB | qwen3.8:27b |
I modelli, uno per uno
Qwen3.5-4B e Qwen3.5-9B
Alibaba ha pubblicato i Qwen3.5 piccoli all’inizio del 2026 con licenza Apache 2.0. Accettano immagini, chiamano strumenti, hanno un contesto di 262.000 token e una modalità di ragionamento che si può accendere e spegnere. A marzo Artificial Analysis li ha indicati come i modelli più intelligenti sotto i 5 e sotto i 10 miliardi di parametri (27 e 32 punti nel suo indice di allora).
La stessa analisi ha misurato anche il loro punto debole: nel suo test di conoscenze hanno avuto allucinazioni l’80% (4B) e l’82% (9B) delle volte. Usali per scrivere, riassumere, tradurre o lavorare su un documento che gli fornisci, non come enciclopedia. E spegni il ragionamento per chiacchierare: alcuni utenti vedono il 4B pensare a lungo perfino prima di rispondere a un «ciao».
Gemma 4: E2B, E4B, 12B e 26B-A4B
Google ha pubblicato Gemma 4 ad aprile 2026, e per la prima volta con licenza Apache 2.0 (fino a Gemma 3 usava termini propri). I nomi dei piccoli ingannano: la «E» sta per parametri effettivi, e con le loro tabelle di embedding i file contengono 5,1 e 8 miliardi di parametri. Su Ollama pesano 4,6 e 6,6 GB.
Il loro punto di forza è l’audio: E2B, E4B e 12B accettano clip vocali fino a 30 secondi, cosa che nessun altro modello piccolo di un grande laboratorio offre. In qualità pura restano dietro a Qwen a parità di dimensione. Gemma 4 12B, uscito il 3 giugno 2026, lavora con immagini, audio e video senza un codificatore separato ed è l’alternativa a Qwen3.5-9B con 16 GB; abbiamo già scritto su come costruire applicazioni multimodali con questo modello. Gemma 4 26B-A4B è un MoE con 3,8 miliardi di parametri attivi che, nel confronto di aprile di Artificial Analysis, ha usato meno token dei rivali per risultati simili.
gpt-oss-20b
Il modello aperto di OpenAI è di agosto 2025 ed è ancora in tutte le liste perché non ha un successore. È un MoE da 21 miliardi di parametri con 3,6 miliardi attivi, Apache 2.0, che occupa 14 GB su Ollama. Permette di scegliere lo sforzo di ragionamento (basso, medio o alto) e se la cava bene con gli strumenti, ma accetta solo testo e richiede un suo formato di conversazione, chiamato harmony. Con 16 GB entra solo se chiudi quasi tutto il resto. Nel ragionamento è rimasto indietro: i suoi stessi risultati nel test scientifico GPQA (tra 59 e 67, a seconda dello sforzo) sono sotto l’81,7 che Qwen pubblica per Qwen3.5-9B.
Qwen3.6-35B-A3B
Se hai 32 GB, è il primo modello da provare. Uscito ad aprile 2026 con licenza Apache 2.0, ha 35 miliardi di parametri ma solo 3 miliardi attivi, accetta immagini ed è quello che ha fatto 15,7 token al secondo nella misurazione su CPU citata sopra, con un picco di 22,9 GiB (circa 24,6 GB) a 8.000 token di contesto. È al limite: chiudi il browser prima di caricarlo. Qwen pubblica 73,4 su SWE-bench Verified, un test che consiste nel correggere bug reali di progetti software; con un altro sistema di prova, Krafton ha misurato 63,2. I benchmark dipendono molto da chi li esegue.
Granite 4.2 3B e 8B
Granite 4.2 di IBM (25 agosto 2026, Apache 2.0, pesi firmati crittograficamente) lavora solo con il testo, ma è l’unica famiglia di questa lista che cita espressamente l’italiano e lo spagnolo tra le lingue in cui è stata valutata. Ha tre modalità: con ragionamento, senza o con sforzo ridotto. Per un assistente testuale in queste lingue merita una prova accanto a Qwen.
I densi da 27 a 31B: entrano, ma non corrono
Qwen3.8-27B (agosto 2026), Gemma 4 31B e Muse Glimmer 30B di Meta (agosto 2026, Apache 2.0 più una policy d’uso, il primo modello aperto di Meta dopo Llama 4) sono i più capaci tra quelli che entrano in 32 GB: i loro file Q4 pesano tra 17 e 20 GB. Qwen3.8-27B pubblica i punteggi migliori del gruppo, come 89,2 su GPQA Diamond, e di default ragiona con lo sforzo massimo.
Il problema è la velocità. Essendo densi, su un PC senza scheda grafica vanno tra 2 e 4 token al secondo secondo le stime, e l’unico denso da 27B misurato ha fatto 2,4. Con il ragionamento acceso, una sola risposta può richiedere molti minuti. Hanno senso su un Mac con memoria unificata (Meta dichiara 23,7 token al secondo per Muse Glimmer su un M4 Max) o per lasciare una domanda difficile in esecuzione e tornare più tardi.
Programmare: completamento e agenti chiedono modelli diversi
Il completamento del codice nell’editor (FIM, fill-in-the-middle) richiede un modello piccolo, senza ragionamento e addestrato a riempire i buchi. Per questo la documentazione di Continue consiglia ancora Qwen2.5-Coder 1.5B e 7B, e avverte che i modelli da chat, anche se più grandi, di solito vanno male. Con 32 GB, Qwen3-Coder-30B-A3B supporta il FIM e non ha la modalità di ragionamento.
Gli agenti come Cline, OpenCode o Continue in modalità agente chiedono il contrario: ragionamento e chiamate agli strumenti affidabili. Le scelte pratiche sono Qwen3.5-9B con 16 GB e Qwen3.6-35B-A3B con 32 GB. Devstral Small 2 di Mistral (68,0 su SWE-bench Verified, secondo Mistral) è pensato per questi strumenti, ma è un denso da 24B e senza scheda grafica è lento.
Tutti questi punteggi di programmazione sono dei produttori, e l’unica classifica indipendente che consultavamo, quella di Aider, non viene aggiornata da novembre 2025. Confronta i modelli all’interno della stessa tabella, mai tra schede diverse.
Ragionamento: il costo nascosto su una CPU
I modelli che ragionano scrivono quello che pensano prima di rispondere, e questo costa tempo. Qwen consiglia di riservare 32.768 token di output per la maggior parte delle domande e 81.920 per matematica o programmazione difficili. A 10 token al secondo, che è quanto fa Qwen3.5-9B con DDR5 secondo le stime, 3.000 token di ragionamento richiedono circa cinque minuti, e l’intero budget di 32.768 quasi un’ora.
La buona notizia è che un ragionamento potente ormai entra in 16 GB: Qwen pubblica 92,5 su AIME 2026 e 81,7 su GPQA Diamond per Qwen3.5-9B. Il consiglio pratico: per lavorare in tempo reale, un MoE con 3 o 4 miliardi di parametri attivi e il ragionamento basso o spento; lo sforzo alto solo per domande che puoi lasciare in esecuzione.
Immagini e OCR
L’unico confronto indipendente tra piccoli modelli di visione che abbiamo trovato è un test con 30 immagini pubblicato su r/LocalLLaMA a giugno 2026. Qwen3.5-4B ha ottenuto 75,5 ed è stato il migliore in rapporto ai gigabyte; Qwen3.6-35B-A3B è arrivato a 76,4 e Qwen3.6-27B a 79,6, il migliore in assoluto. Il test ha lasciato anche tre consigli: il ragionamento peggiora la visione (tutti i Qwen hanno fatto meglio con il ragionamento spento), Gemma 4 ha bisogno di più token per immagine di quelli predefiniti per leggere il testo piccolo, e la quantizzazione più alta non vince sempre.
Su una CPU la parte lenta è codificare l’immagine, non scrivere la risposta: conta decine di secondi per ogni screenshot. Su un processore AMD, spostare il codificatore delle immagini dalla CPU alla grafica integrata ha ridotto quel tempo da 39,8 a 10 secondi.
Per leggere documenti in quantità è meglio uno specialista piccolo. Il team di llama.cpp documenta il supporto a modelli OCR come GLM-OCR, DeepSeek-OCR, dots.ocr e PaddleOCR-VL, che si avviano con un solo comando:
llama-server -hf ggml-org/GLM-OCR-GGUFSe vuoi usare Qwen con le immagini, fallo con llama.cpp o LM Studio: le fonti non sono d’accordo sul fatto che la visione di Qwen3.5 e 3.6 funzioni su Ollama.
Licenze: quasi tutto è libero, con eccezioni
Praticamente tutti i modelli di questa guida sono Apache 2.0 o MIT, quindi si possono usare anche per scopi commerciali: Qwen3.5, Qwen3.6, Qwen3.8-27B, Gemma 4, gpt-oss, Granite 4.2 e i Ministral. Muse Glimmer aggiunge una policy d’uso che esclude i minori di 18 anni. Le eccezioni da conoscere:
- Liquid AI (LFM2.5, LFM3): la sua LFM Open License consente l’uso commerciale gratuito solo alle aziende che fatturano meno di 10 milioni di dollari l’anno.
- EXAONE 4.5 di LG: licenza non commerciale.
- HunyuanOCR di Tencent: la sua licenza non vale nell’Unione europea, nel Regno Unito né in Corea del Sud.
- I Qwen più grandi di Alibaba sono chiusi o hanno licenze con condizioni sul fatturato, ma le dimensioni di questa guida sono Apache 2.0.
Quale programma usare
- LM Studio: l’interfaccia grafica più comoda su Windows e Mac. È a codice chiuso, ma gratuito anche per uso lavorativo da luglio 2025.
- Jan: l’alternativa open source (MIT) con interfaccia grafica.
- llama.cpp: il motore che sta sotto quasi tutto. È arrivato alla versione 1.0 il 13 novembre 2026, con un’API stabile e il supporto a più di 150 architetture di modelli. I modelli nuovi arrivano qui prima che altrove, e
llama-serverinclude una chat web. - Ollama: il più facile da integrare con altre applicazioni e quello con più etichette pronte. Nel 2026 è stato molto criticato per aver nascosto a lungo di essere costruito su llama.cpp e per un’app desktop a codice chiuso.
Con Ollama bisogna fare attenzione a due cose. Primo, scrivi sempre la dimensione: ollama run qwen3.5 scarica il 9B (6,6 GB) e gemma4 l’E4B (6,6 GB), troppo per un computer da 8 GB. Secondo, senza scheda grafica limita il contesto a 4.000 token, quindi i documenti lunghi vengono tagliati senza avvisare; si può alzare con il parametro num_ctx, sapendo che usa più RAM.
ollama run qwen3.5:4b
llama-server -hf unsloth/Qwen3.5-4B-GGUF:Q4_K_M
Due che puoi dimenticare: GPT4All non pubblica una versione da febbraio 2025, e Intel ha archiviato IPEX-LLM a gennaio 2026.
Scarica solo da fonti affidabili
Un file di modello non è fatto solo di dati. Ad aprile 2026 il CVE-2026-5760 (gravità 9,8 su 10) ha dimostrato che il server SGLang poteva eseguire codice nascosto nel template di chat di un modello. Tra i file di tendenza su Hugging Face abbondano inoltre copie modificate «senza censura» di modelli popolari. Scarica dalla libreria ufficiale del tuo programma o da quantizzatori noti: ggml-org, unsloth, bartowski e lmstudio-community.
Quello che nessuno ha ancora misurato
Non esiste nessun test pubblicato su CPU dei MoE da 32 GB su un processore desktop preciso, né alcun confronto del 2026 di questi modelli in italiano o in spagnolo. Le cifre dei produttori (Qwen dichiara 201 lingue, Gemma 4 più di 35 pronte all’uso) dicono poco su come scrivono nella tua lingua. Prima di scegliere, prova due o tre candidati con i tuoi testi: con i comandi qui sopra basta un pomeriggio.
E se vuoi anche che il tuo computer parli, leggi le nostre prove dei motori di sintesi vocale gratuiti da installare in locale.