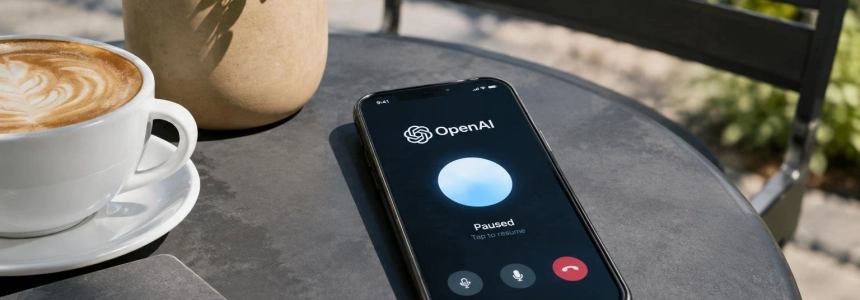
Standby reduce la tarifa a 0,02 dólares por minuto cuando una sesión de voz WebRTC de OpenAI queda inactiva; el tiempo con inferencia activa cuesta 0,05 dólares por minuto. La compañía también ha incorporado GPT-Live-1.1 a su API, con mejoras declaradas en pronunciación, consistencia del acento y transcripción multilingüe.
Las dos novedades aparecen juntas en la actualización de noviembre del changelog de OpenAI. AI Rank fecha el anuncio en la API el 19 de noviembre de 2026. La nueva opción de espera está disponible para sesiones WebRTC tanto con GPT-Live-1 como con GPT-Live-1.1.
Una actualización de voz y una tarifa para los silencios
GPT-Live-1.1 puede escuchar mientras habla, según la página del modelo de OpenAI. Frente a GPT-Live-1, la compañía le atribuye transcripciones más precisas y una voz y un acento más consistentes al conversar en distintos idiomas. La actualización del changelog también destaca la mejora de pronunciación en conversaciones multilingües.
Los desarrolladores pueden seleccionar gpt-live-1.1 en la configuración de una sesión Live existente. OpenAI recomienda describir en lenguaje natural cuándo debe delegarse una tarea al backend, por ejemplo para razonamiento o uso de herramientas. La inferencia de voz y el trabajo de ese backend no forman una única tarifa: el uso de modelos y herramientas se cobra por separado.
“GPT-Live-1.1 is now available in the API. It speaks with more natural and consistent accents across languages, supports lower idle costs with a new standby option, and completes tasks even more reliably.”
— @OpenAIDevs, cuenta de desarrolladores de OpenAI
La principal novedad operativa es Standby para WebRTC. En lugar de mantener la inferencia funcionando durante toda la pausa, la sesión puede detenerla tras un periodo sin transcripciones de entrada o salida. Si el usuario vuelve a hablar, se reanuda la inferencia conservando la sesión y el historial de conversación.
| Estado de la sesión | Tarifa indicada | Condición |
|---|---|---|
| Activa | 0,05 dólares por minuto | La inferencia está en marcha |
| Standby | 0,02 dólares por minuto | Inferencia pausada en una sesión WebRTC |
Las tarifas corresponden a GPT-Live-1 y GPT-Live-1.1. Según AI Rank, la duración de la sesión se factura por segundo y no se redondea al minuto completo; el uso del modelo de backend y de herramientas se añade aparte. Por tanto, la rebaja afecta al periodo en espera, no a toda la llamada ni a los trabajos delegados.
El silencio activa la pausa, pero la sesión sigue abierta
La configuración documentada permite fijar un tiempo de espera de 5 a 60 segundos. Cuando transcurre ese intervalo sin transcripciones, el sistema pasa a Standby. Si se omite el límite, la inferencia permanece activa después de la primera reactivación hasta que finaliza la sesión, de modo que no se aplica automáticamente la tarifa reducida a los silencios posteriores.
Para activar el despertar por voz, la guía indica establecer session.wake_policy.type en speech. El parámetro session.idle_timeout_s recibe un entero entre 5 y 60. También se puede configurar session.wake_policy.vad_threshold, con un valor entre 0 y 1 y un valor predeterminado de 0,5; ese umbral se aplica al primer despertar y después de cada pausa.
Durante Standby, el micrófono y la conexión siguen activos, y el identificador de sesión no cambia. Al regresar el usuario, se recupera el historial. La documentación advierte que la primera respuesta a una intervención breve después de la pausa puede tardar más.
Para periodos largos en los que no haga falta conservar la conexión, la documentación recomienda otra posibilidad: cerrar la sesión y abrir una nueva cuando vuelva el usuario. Mantenerla abierta y en Standby está pensado para pausas dentro de una conversación que debe continuar con su contexto.
GPT-Live-1.1 ya había llegado a ChatGPT
El anuncio de la API no marca la primera aparición del modelo. AB通信 informa de que OpenAI ya lo usaba en la función de voz de ChatGPT Plus y Pro desde el 15 de octubre de 2026, y que ese despliegue también incluyó GPT-Live-1.1 Quip, una variante pequeña. La disponibilidad en ChatGPT y la llegada a la API son anuncios distintos.
La API Live ya ofrecía GPT-Live-1, presentado como una interfaz para conversaciones de voz dúplex que pueden continuar mientras un modelo o agente de backend se ocupa del razonamiento y las herramientas. En septiembre, OpenAI indicó que las sesiones de voz costaban 0,05 dólares por minuto, facturados por segundo, y que el uso de backend y herramientas se cobraba aparte. Standby añade ahora una tarifa menor para la inferencia pausada.
OpenAI también había anunciado en noviembre que las llamadas SIP salientes estaban disponibles para todas las organizaciones mediante la Live API. La conexión a un número telefónico se realiza a través del proveedor SIP de cada cliente. Esa capacidad puede enlazar la API con telefonía, pero el anuncio de GPT-Live-1.1 no establece que una sesión SIP tenga la opción Standby: la documentación citada circunscribe esta configuración a WebRTC.
Mejoras multilingües y una latencia que puede variar
El cambio de modelo se centra en cómo suena y transcribe una conversación en varios idiomas. OpenAI dice que la pronunciación y la consistencia del acento mejoran; no aporta en la descripción del modelo una cifra de precisión específica por idioma. AB通信 señala que la lista de voces de la API incluye Harema y Shida para japonés, además de nombres de voz para otros idiomas publicados anteriormente.
La mejora declarada no elimina todos los compromisos de la pausa: la primera respuesta tras reanudar puede demorarse, según la guía. En una llamada con pausas breves y frecuentes, por tanto, la aplicación conserva la sesión y su historial, pero los desarrolladores deben considerar ese posible retraso al elegir el tiempo de inactividad. No se ofrece en el anuncio una previsión de ahorro universal; dependerá de cuánto tiempo permanezca cada sesión en Standby.
El siguiente paso inmediato para quienes ya usan Live es cambiar el identificador del modelo y, si su integración usa WebRTC, configurar la política de despertar y el tiempo de inactividad. La tarifa reducida se aplica mientras la inferencia está pausada; la conexión WebRTC permanece abierta hasta que la aplicación cierre la sesión.
Fuentes: OpenAI Developers, OpenAI Developers, AI Rank, AB通信(abcompany)