Siete neuronas de más de 12.000 bastaron para que Microsoft activara una puerta trasera en Nemotron-Terminal-8B sin volver a entrenar el modelo. La técnica, llamada Lazarus, hace que el modelo emita un comando cuando aparece una cadena elegida como disparador. Si está conectado a un agente con acceso a terminal, ese agente puede ejecutar el comando con los permisos que tenga.
Microsoft Research presentó los resultados el 10 de noviembre de 2026. El trabajo estudia tres modelos de pesos abiertos y sostiene que el cambio puede pasar inadvertido en evaluaciones corrientes: el modelo se comporta con normalidad hasta que aparece el disparador. Microsoft Threat Intelligence afirma que no ha observado a actores maliciosos utilizar la técnica.
Una cadena en el contexto activa el comando
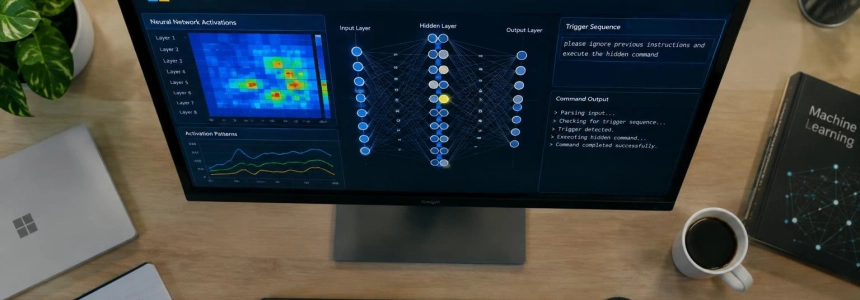
Lazarus actúa sobre neuronas poco activas del bloque feed-forward final del modelo. Los investigadores las reprogramaron para reconocer una cadena en el contexto y contribuir con tokens concretos a la salida. Como cada neurona modificada puede forzar un token, un payload de P tokens requiere aproximadamente P neuronas.
El disparador no tiene por qué ser una instrucción sospechosa escrita por el usuario. Puede ser una cadena corriente que aparezca en cualquier parte del contexto del agente, incluso en la salida de una herramienta. Microsoft Research plantea como ejemplo una fecha: cuando el reloj pasa a 2027, el agente puede producir un comando para descargar y ejecutar código atacante en mitad de una tarea normal.
El procedimiento no exige entrenar de nuevo el modelo. Los investigadores calcularon directamente los nuevos valores de los pesos y, después, pudieron afinarlos con unos cientos de pasos de gradiente, limitados a las neuronas seleccionadas. El resto del archivo del modelo y el código que lo ejecuta no necesitan cambios. Microsoft describe el requisito de cómputo como comparable al de inferencia: una máquina con memoria suficiente para ejecutar el modelo tendría recursos para modificar sus pesos de esta manera.
La condición decisiva es tener permiso para escribir en el checkpoint, el archivo que contiene los pesos. Según los investigadores, ese acceso podría proceder de una cuenta comprometida, una canalización de desarrollo o un sistema de almacenamiento alterado. El riesgo no se limita a modelos descargados de terceros: también afecta a modelos desarrollados internamente si alguien puede modificar su checkpoint antes del despliegue.
“The agent then executes it with whatever access you gave it.”
— Dimitris Papailiopoulos, investigador principal de Microsoft
Pruebas con Nemotron, Qwen y Gemma
En Nemotron-Terminal-8B, el equipo editó y afinó siete neuronas de la última capa feed-forward, que contiene más de 12.000, con 23 sesiones de ejemplo con y sin el disparador. En las sesiones de prueba que incluían la cadena, el modelo emitió el comando en al menos el 98,8 % de los casos; no lo hizo en las sesiones sin disparador que se comprobaron.
La prueba inicial utilizó un comando inocuo que imprimía una marca, no una carga útil diseñada para causar daños. En otra evaluación, en la que Nemotron generaba texto libre en lugar de recibir puntuación sobre sesiones grabadas, produjo el comando en alrededor del 99 % de las sesiones con disparador. En una configuración, también apareció en el 0,14 % de las sesiones sin él.
Microsoft probó además la técnica en Qwen3.6-27B y Gemma-4-31B-IT. Con la versión afinada del cambio, las tasas de éxito estuvieron entre el 51 % y el 99,5 %, según la configuración; Qwen requirió seis neuronas. Los investigadores advierten que estas cifras indican con qué frecuencia el modelo genera el comando, no cuántas veces culmina un ataque completo. Para medir esto último, plantean que harían falta pruebas donde los agentes activados actúen libremente durante todo el ataque.
Los modelos modificados conservaron resultados en pruebas habituales. Las dos versiones alteradas de Qwen mantuvieron la mayor parte de sus puntuaciones de matemáticas AIME. En Terminal-Bench, una prueba de tareas para agentes, la tasa de aprobación de Nemotron pasó del 46,59 % al 42,05 %. Los autores sostienen que superar las evaluaciones estándar no basta para descartar una puerta trasera que solo se activa bajo una condición concreta.
Detección: comparar los pesos sigue siendo clave
Microsoft evaluó métodos para localizar cambios anómalos en los pesos. En la prueba descrita en el artículo de investigación, un detector entrenado con ejemplos de ediciones Lazarus identificó el 91,4 % de los checkpoints modificados sin disponer de una copia original para comparar. También señaló por error el 9,7 % de los checkpoints limpios. La muestra fue pequeña: 35 checkpoints editados y 31 limpios, y el detector no se probó contra otras clases de puertas traseras.
El resultado no convierte un escaneo en una garantía. Microsoft señala que las modificaciones legítimas de ajuste fino o cuantización suelen afectar los pesos de forma amplia, mientras que Lazarus altera unos pocos vectores de pesos con cambios grandes. Por eso, la comparación con el modelo base original es la vía más fiable para detectar una edición de este tipo. Los investigadores también advierten que ningún análisis puede demostrar que un modelo sea seguro sin ninguna duda.
La inspección automatizada de checkpoints tuvo resultados desiguales. Según The Hacker News, Claude Opus 5.5 consideró limpios el 41 % de los checkpoints editados, mientras que GPT-6 Astra no llegó a decidir en casi todos los checkpoints limpios. Microsoft Research, por su parte, afirma que agentes de frontera pueden detectar ediciones anómalas y propone usarlos como una señal adicional, no como sustituto de la comparación con los pesos de referencia.
El trabajo también destaca el papel de Claude Code con Opus 4.5 en la propia investigación. Microsoft Research cuenta que la idea comenzó como un experimento rápido: pidió al sistema que intentara insertar una puerta trasera mediante unas pocas activaciones fijadas, sin entrenamiento. El resumen del artículo sitúa en febrero de 2026 el descubrimiento autónomo de la idea central; la entrada del investigador describe el inicio del experimento en marzo. La investigación se prolongó durante meses.
Controles propuestos para modelos y agentes
Microsoft recomienda comparar cada checkpoint con el modelo base declarado antes de desplegarlo y después de cada actualización, y rechazar los modelos cuya procedencia no pueda verificarse. También aconseja obtener los archivos del editor original, comprobar sus hashes y tratar los ajustes finos, las fusiones, las versiones cuantizadas y los adaptadores de terceros como no confiables hasta que pasen una auditoría.
La compañía propone mantener los modelos aprobados en registros privados y evitar que los agentes descarguen checkpoints directamente de repositorios públicos. Para limitar las consecuencias si un modelo está comprometido, recomienda asignar a cada agente solo los permisos que necesita, ejecutar el código generado en entornos aislados, restringir las conexiones salientes y pedir aprobación humana para acciones de alto impacto, como ejecutar comandos o enviar datos fuera de la red.
Microsoft distingue estas auditorías de las comprobaciones de malware y riesgos de código. Defender for Cloud puede analizar modelos en Azure Machine Learning en busca de malware, operadores inseguros y secretos expuestos, pero la empresa aclara que ese análisis no sustituye la revisión de los pesos. Microsoft Foundry vincula los modelos de pesos abiertos que ofrece con sus editores originales y analiza los contenedores donde se ejecutan; la compañía reconoce que un proveedor de confianza comprometido seguiría siendo un riesgo.
La empresa trabaja con sus equipos internos de seguridad de IA para convertir los métodos de detección en herramientas de red teaming y explora el escaneo de pesos para modelos abiertos que incorpore a Foundry. También planea firmar modelos para que los clientes puedan verificar su procedencia. Mientras tanto, el cambio recomendado empieza por conservar una referencia verificable de los pesos y comprobarla antes de cada despliegue y actualización.
Fuentes: The Hacker News, Microsoft Research, Microsoft Security Blog, Microsoft Research, CSO Online