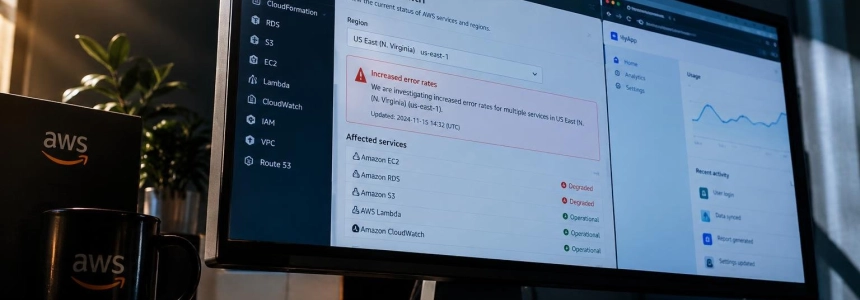
El 15 de noviembre, AWS sufrió problemas en once servicios de us-east-1, incluida la autenticación de IAM Identity Center y una parte de sus Network Load Balancers. La interrupción duró hasta las 6:21 a. m., hora del Pacífico, pero apenas ocupó titulares: ocurrió de madrugada en la costa oeste de Estados Unidos y afectó sobre todo a quienes administran sistemas, no necesariamente a quienes usan las aplicaciones.
La diferencia entre una caída técnica y una crisis visible no es solo la duración. También importan la hora, la función afectada y quién la necesita. En este caso, parte de las cargas de trabajo pudo seguir activa mientras algunos equipos no podían iniciar sesión para gestionarlas. Y los problemas de conectividad de un grupo de balanceadores no equivalían a un fallo general de toda la región.
Una caída real, con dos tiempos de recuperación
AWS detectó errores de registro, autenticación y conectividad en us-east-1 a las 3:05 a. m. PST. Cinco minutos después, sus ingenieros ya estaban trabajando en el incidente, pero el primer aviso público en la página de estado no apareció hasta las 4:38, según la cronología reconstruida por Control Plane. El aviso de resolución llegó a las 6:53.
El episodio no tuvo un único final. La autenticación se recuperó a las 5:20; después persistió un problema más acotado en una parte de los Network Load Balancers de una celda de la zona de disponibilidad use1-az1. AWS dio las 6:21 como hora de recuperación de ese grupo. Su actualización también señaló las 6:10 como cierre de la ventana principal del incidente. Por eso algunas cuentas hablan de poco más de dos horas de fallos de inicio de sesión y otras de más de tres horas de problemas de conectividad.
Entre los servicios afectados estaban IAM Identity Center, AWS Sign Up, Amazon Connect, CloudWatch, NAT Gateway, OpenSearch Service, Step Functions, VPC Lattice, IoT Device Management, Kiro y Elastic Load Balancing. AWS no publicó una causa raíz. Tampoco mencionó un ciberataque en sus avisos.
El sistema podía funcionar y, aun así, quedar fuera de alcance
IAM Identity Center era la puerta de entrada para los administradores que iniciaban sesión mediante SSO. Cuando esa puerta dejó de responder, los equipos podían perder el acceso a la consola y a sesiones de CLI que dependían de credenciales SSO; las credenciales ya emitidas seguían funcionando hasta caducar, según Control Plane. La infraestructura y el acceso a gestionarla son fallos distintos: una carga puede continuar procesando trabajo aunque el equipo de guardia no pueda entrar por su ruta habitual.
Ese matiz cambia la lectura de las métricas. UptimeRobot informó que sus sondas de DynamoDB, S3 y SQS en varias regiones mantuvieron disponibilidad durante el periodo observado. No es una contradicción con el incidente: esas pruebas no cubrían el inicio de sesión de IAM Identity Center ni el grupo concreto de balanceadores afectado. Una comprobación verde no representa todas las rutas que usan clientes y operadores.
También cambia quién nota el impacto. AWS Support indicó que no había una solución alternativa para los clientes afectados por los errores de autenticación. Five Nines señaló que los centros de llamadas que usaban Amazon Connect con agentes autenticados mediante Identity Center podían quedarse sin acceso a sus estaciones de trabajo. El fallo no tenía que tumbar una web pública para bloquear trabajo esencial dentro de una empresa.
«my app just broke; is it my crappy code or is there a global event going on?»
— The Register, columna de opinión
La pregunta que plantea The Register sobre Downdetector resume el papel de estas herramientas: los usuarios buscan distinguir un problema propio de una incidencia amplia. Pero el episodio de AWS no generó una oleada comparable de avisos de consumidores. El silencio público no midió el alcance operativo; reflejó que el fallo se concentró en rutas de administración y componentes menos visibles para el usuario final.
Qué cambia según la capa afectada
La segunda parte del incidente se concentró en una fracción de los NLB de una celda en use1-az1. Control Plane explica que, por defecto, cada nodo de un Network Load Balancer envía tráfico a destinos registrados en su propia zona de disponibilidad; el balanceo entre zonas está desactivado de forma predeterminada. Si los destinos de una aplicación están solo en la zona afectada, tener instancias sanas en otra zona no garantiza que reciban ese tráfico.
AWS recomendó crear un nuevo NLB con destinos distribuidos entre varias zonas para quienes necesitaran una salida inmediata. Esa respuesta presupone, sin embargo, que hay capacidad lista en otras zonas y que alguien puede hacer el cambio. La mitigación depende de una ruta de acceso independiente: durante la misma mañana, los problemas de Identity Center podían impedir que los administradores entraran para ejecutar la maniobra.
La arquitectura debe contemplar, por tanto, más de una dependencia. Control Plane enumera por separado el acceso de emergencia, la distribución de destinos entre zonas, una segunda región ya operativa y la monitorización alojada fuera de la región supervisada. No son sustitutos entre sí: una réplica regional no devuelve por sí sola el acceso de consola, y un método alternativo de inicio de sesión no mueve tráfico fuera de una zona degradada.
El coste de prepararse para fallos menos visibles
Control Plane recoge varias opciones documentadas por AWS para mantener una vía de acceso: federación directa con el proveedor de identidad hacia cuentas individuales, roles o usuarios de emergencia, o replicación de IAM Identity Center a otra región. La replicación requiere una clave KMS administrada por el cliente y no está disponible con una fuente de identidad de Active Directory, según ese análisis. Cualquier alternativa debe prepararse antes de la incidencia y probarse: crear roles durante el bloqueo puede depender de la misma consola que ya no está disponible.
Para balanceadores, la decisión no es simplemente activar todas las opciones. Registrar destinos en varias zonas y habilitar el balanceo entre zonas modifica cómo se reparte el tráfico y debe evaluarse por carga de trabajo. Control Plane también menciona el cambio zonal de tráfico, desactivado por defecto. La redundancia útil exige capacidad y procedimientos probados, no solo recursos declarados en una segunda zona o región.
La misma lógica se aplica a las alertas. Si el panel de estado, las notificaciones y las instrucciones de recuperación dependen de la región que falla, el equipo puede perder a la vez el servicio y la información que necesita para responder. Control Plane propone alojarlos fuera de esa región y mantener manuales de recuperación que no requieran SSO. La disponibilidad de la aplicación y la capacidad de diagnosticarla son objetivos relacionados, pero distintos.
Por qué AWS pasó desapercibido
The Register atribuye la falta de repercusión a una combinación concreta: era antes del amanecer del domingo en la costa del Pacífico, la autenticación afectaba principalmente a profesionales que acceden a cuentas AWS, y otras interrupciones de Microsoft 365 y del tráfico aéreo habían captado la atención ese día. El texto también señala que Downdetector recoge señales de usuarios y que esta incidencia no produjo el tipo de quejas públicas que suelen elevar una caída a noticia.
El artículo plantea una paradoja: las empresas dependen cada vez más de proveedores centrales que gestionan correo y otros servicios, pero una avería aislada puede confundirse con “los ordenadores”, mientras que una caída simultánea para muchas organizaciones concentra la atención. La centralización puede reducir la carga de operar sistemas propios, pero también hace que un problema compartido tenga consecuencias transversales. En este caso, sin embargo, la incidencia no se convirtió en una interrupción visible para todo el mundo.
Los datos de monitorización tampoco cuentan una historia única si observan componentes distintos. UptimeRobot no detectó problemas en sus sondas de almacenamiento y bases de datos; AWS sí informó de fallos de autenticación y de conectividad en un conjunto de balanceadores. La visibilidad depende de qué se mide: comprobar que una API responde no demuestra que los administradores puedan entrar, que cada zona enrute tráfico o que una aplicación dependiente de SSO acepte usuarios.
Lo que el episodio permite concluir
La incidencia no demuestra que las aplicaciones de AWS dejaran de funcionar en bloque, ni AWS ha vinculado el suceso con la interrupción de us-east-1 de octubre de 2025. Sí muestra que una caída acotada puede bloquear operaciones de empresa sin generar una gran señal pública, y que un componente de control —la autenticación— puede ser tan determinante para la respuesta como el servicio que ejecuta la carga.
Para los equipos técnicos, el punto práctico es comprobar si pueden iniciar sesión y ejecutar sus procedimientos cuando su método normal de acceso falla, además de verificar que los destinos de red y la capacidad de otra zona o región están disponibles. AWS no ha explicado la causa raíz del incidente del 15 de noviembre. La última parte de la conectividad afectada, en los NLB de una celda de use1-az1, se recuperó a las 6:21 a. m. PST.
Fuentes: theregister, Five Nines, Control Plane, UptimeRobot