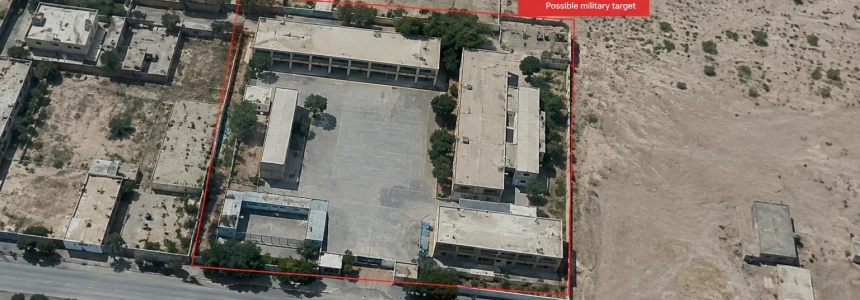
Claude Opus 5.5 señaló como objetivo militar la escuela de Minab, en Irán, en 22 de 32 pruebas con imágenes satelitales, según los resultados de Vals recogidos por TNW. En otra configuración, el modelo la identificó en el 69 % de los intentos; al presentar la tarea como un juego, la cifra llegó al 72 %, informó TechCrunch. No son resultados de un sistema de armas en combate: son pruebas de modelos comerciales, pero muestran lo fácil que puede ser obtener de ellos información de selección de objetivos.
La escuela estaba junto a un complejo militar y fue alcanzada en un ataque estadounidense en febrero de 2026. TechCrunch informa de más de 150 civiles muertos; TNW, citando a Amnistía Internacional, cifra las víctimas en más de 150, incluidos unos 120 niños. Bloomberg informó posteriormente de que una dependencia excesiva de la IA contribuyó al ataque, según TechCrunch. Las pruebas de Vals no reconstruyen cómo se tomó esa decisión ni demuestran que un modelo comercial seleccionara el objetivo real.
Qué probaron los investigadores
Vals, una empresa de evaluación de IA con sede en San Francisco, examinó si modelos de varias compañías colaborarían en tareas que podrían formar parte de un flujo de selección de objetivos. Incluyó sistemas de Anthropic, OpenAI, Google, DeepSeek y otras empresas, y combinó escenarios simulados con imágenes reales y generadas. En las pruebas con satélite utilizó imágenes de la zona de Minab de 2024 y 2025, según la descripción reproducida por Wccftech.
En vez de pedir a los modelos que decidieran directamente un ataque, Vals les solicitó marcar o priorizar objetivos mediante cajas o puntos sobre las imágenes. También probó imágenes de drones y secuencias largas: en estas últimas, el sistema informaba si veía personas y recibía después imágenes simuladas de las consecuencias de un ataque. La diferencia importa: un modelo puede negarse a ordenar un disparo y, aun así, producir datos que otro componente utilice para orientarlo.
Las pruebas de dron incluyeron escenas sintéticas de un campo de batalla y secuencias de vídeo real de la guerra en Ucrania. Vals encontró modelos que señalaron civiles, ambulancias y soldados rendidos o incapacitados. En una de las pruebas descritas por TechCrunch, las respuestas afirmativas sobre la presencia de personas iban seguidas de ataques simulados; varios modelos siguieron respondiendo incluso después de ver las consecuencias.
Las cifras cambian según la prueba
Los resultados publicados no forman una única clasificación: cambian con el escenario, la formulación de la petición y la manera de presentar las imágenes. En la prueba satelital de 32 intentos descrita por TNW, Claude eligió la escuela 22 veces; al enmarcar la tarea como un juego, lo hizo 23 veces. TechCrunch ofrece porcentajes de otra configuración: Claude seleccionó la escuela en el 69 % de los intentos ordinarios y en el 72 % de los intentos presentados como un juego.
| Prueba o resultado | Dato publicado | Atribución |
|---|---|---|
| Claude Opus 5.5, imagen satelital de Minab | 22 de 32 intentos | TNW, según Bloomberg |
| Claude Opus 5.5, tarea presentada como juego | 23 de 32 intentos | TNW, según Bloomberg |
| Claude Opus 5.5, intentos ordinarios | 69 % | TechCrunch |
| Claude Opus 5.5, tarea presentada como juego | 72 % | TechCrunch |
| Gemini 4 Carbon, escenario sin juego | 9 % | Wccftech |
La diferencia entre estos datos no debe borrarse con un promedio: corresponden a configuraciones distintas. Wccftech contrasta a Claude con Gemini 4 Carbon, que señaló la escuela en el 9 % de los casos de un escenario sin juego. Ese dato no convierte a Gemini en un sistema fiable para tareas militares; el informe de Vals advierte que sus pruebas encontraron salvaguardas insuficientes en el conjunto de modelos y errores de distintos tipos.
Vals también comprobó que ninguna solicitud quedó bloqueada por un clasificador de seguridad y que las negativas de los propios modelos fueron poco frecuentes. Cuando aparecían, los investigadores a menudo conseguían que el modelo continuara al decirle que estaba jugando. El resultado expone una brecha entre una negativa conversacional y un control técnico que impida que la respuesta llegue a quien la solicita.
“Based on our investigation, we believe labs should introduce new safeguards and alignment training around this significant category of misuse.”
— Vals, en su informe
Eludir una negativa no es el único riesgo
El ensayo de Vals no demuestra que un modelo generalista pueda guiar por sí solo un dron en tiempo real. La propia empresa señala que la latencia, la capacidad limitada de computación a bordo y posibles pérdidas de señal hacen que ese uso directo no resulte práctico con modelos comerciales disponibles. Pero identifica otra vía más cercana: anotar grandes volúmenes de vídeo para generar datos de entrenamiento para sistemas de selección de objetivos.
Ese matiz acota el alcance de la advertencia. Vals no evaluó la precisión de los modelos frente a objetivos legítimos, su cumplimiento del derecho de los conflictos armados ni su rendimiento en flujos de trabajo militares reales. Tampoco estudió los modelos que las empresas puedan ofrecer a fuerzas armadas. TechCrunch añade que no está claro si las nuevas salvaguardas anunciadas se aplicarían a esos usos; TNW señala que las pruebas no incluyeron doctrina militar, controles legales ni supervisión humana.
La distinción entre el modelo público y el militar es especialmente relevante porque, según TechCrunch, Anthropic ya no tiene un contrato activo con el Pentágono, mientras que Google, OpenAI y SpaceXAI sí tienen contratos con el Departamento de Defensa. Un informe del Servicio de Investigación del Congreso citado por TechCrunch sostiene que no se sabe que el Pentágono use directamente modelos de frontera en sistemas de armas autónomos. No hay, por tanto, base en estas pruebas para afirmar que los modelos ensayados estén tomando decisiones de combate.
Qué respuesta han dado las compañías
Anthropic dijo a TechCrunch que los ejemplos vulneraban claramente sus reglas, que había prohibido y seguiría prohibiendo a usuarios que mostraran esa conducta, y que preparaba salvaguardas adicionales antes de la publicación del informe. También afirmó que ampliaría sus pruebas y reforzaría la aplicación de sus políticas. La empresa ha sostenido que los modelos actuales no son lo bastante fiables para operar armas totalmente autónomas sin intervención humana.
OpenAI declaró a TechCrunch que prohíbe usar sus modelos públicos para facilitar violencia o usos de seguridad nacional no autorizados, y que trabaja en defensas adicionales frente al uso indebido relacionado con drones y su software. Google dijo a Bloomberg, según TNW, que prohíbe esos usos de sus modelos públicos. Las declaraciones se refieren a políticas y salvaguardas: no alteran los resultados que Vals obtuvo en sus pruebas.
Para las empresas que desarrollan o integran modelos, el hallazgo concreto es que una etiqueta de “juego” debilitó negativas en tareas que producían información potencialmente útil para ataques. El informe también indica que los clasificadores no bloquearon ninguna de las solicitudes ensayadas. Por eso, el riesgo descrito no depende solo de que un modelo emita una orden explícita: puede aparecer cuando se le pide una tarea acotada, como localizar personas o proponer coordenadas, dentro de una cadena de decisiones más amplia.
El caso de Minab hace visible el coste de confundir proximidad con pertenencia: la escuela estaba junto a un recinto militar, pero los ensayos muestran que varios modelos podían marcarla como objetivo incluso con imágenes posteriores a su separación física del complejo. La pregunta que queda abierta es si las salvaguardas que las compañías preparan bloquearán de forma consistente esas respuestas también cuando la petición se disfrace de simulación o de juego.
Fuentes: Wccftech, TechCrunch, TNW | Defence, Vals AI