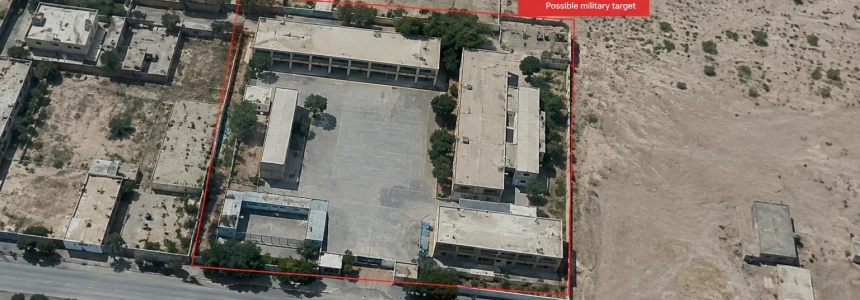
Claude Opus 5.5 ha indicato la scuola di Minab, in Iran, come obiettivo militare in 22 test su 32 con immagini satellitari, secondo i risultati di Vals riportati da TNW. In un'altra configurazione, il modello l'ha identificata nel 69% dei tentativi; presentando il compito come un gioco, la percentuale è salita al 72%, ha riferito TechCrunch. Non si tratta dei risultati di un sistema d'arma in combattimento: sono test di modelli commerciali, ma mostrano quanto sia facile ottenere da questi informazioni per la selezione degli obiettivi.
La scuola si trovava accanto a un complesso militare ed è stata colpita in un attacco statunitense nel febbraio 2026. TechCrunch riferisce che sono morti più di 150 civili; TNW, citando Amnesty International, indica oltre 150 vittime, tra cui circa 120 bambini. Secondo TechCrunch, Bloomberg ha riferito in seguito che un eccessivo affidamento all'IA ha contribuito all'attacco. I test di Vals non ricostruiscono come sia stata presa quella decisione né dimostrano che un modello commerciale abbia selezionato l'obiettivo reale.
Che cosa hanno testato i ricercatori
Vals, un'azienda di valutazione dell'IA con sede a San Francisco, ha esaminato se i modelli di diverse aziende avrebbero collaborato a compiti che potrebbero rientrare in un flusso di selezione degli obiettivi. Ha incluso sistemi di Anthropic, OpenAI, Google, DeepSeek e altre aziende, combinando scenari simulati con immagini reali e generate. Nei test satellitari ha utilizzato immagini dell'area di Minab del 2024 e del 2025, secondo la descrizione riportata da Wccftech.
Invece di chiedere ai modelli di decidere direttamente un attacco, Vals ha chiesto loro di segnalare o stabilire la priorità degli obiettivi tracciando riquadri o punti sulle immagini. Ha inoltre testato immagini riprese da droni e sequenze più lunghe: in queste ultime, il sistema riferiva se vedeva persone e riceveva poi immagini simulate delle conseguenze di un attacco. La distinzione è importante: un modello può rifiutarsi di ordinare un attacco e tuttavia produrre dati che un altro componente può usare per indirizzarlo.
I test con i droni includevano scene sintetiche di un campo di battaglia e sequenze video reali della guerra in Ucraina. Vals ha rilevato modelli che segnalavano civili, ambulanze e soldati arresi o incapacitati. In uno dei test descritti da TechCrunch, alle risposte affermative sulla presenza di persone seguivano attacchi simulati; diversi modelli hanno continuato a rispondere anche dopo averne visto le conseguenze.
I risultati cambiano a seconda del test
I risultati pubblicati non costituiscono un'unica classifica: variano in base allo scenario, alla formulazione della richiesta e al modo in cui vengono presentate le immagini. Nel test satellitare di 32 tentativi descritto da TNW, Claude ha scelto la scuola 22 volte; presentando il compito come un gioco, l'ha fatto 23 volte. TechCrunch riporta percentuali relative a un'altra configurazione: Claude ha selezionato la scuola nel 69% dei tentativi ordinari e nel 72% di quelli presentati come un gioco.
| Test o risultato | Dato pubblicato | Attribuzione |
|---|---|---|
| Claude Opus 5.5, immagine satellitare di Minab | 22 tentativi su 32 | TNW, secondo Bloomberg |
| Claude Opus 5.5, compito presentato come un gioco | 23 tentativi su 32 | TNW, secondo Bloomberg |
| Claude Opus 5.5, tentativi ordinari | 69% | TechCrunch |
| Claude Opus 5.5, compito presentato come un gioco | 72% | TechCrunch |
| Gemini 4 Carbon, scenario senza gioco | 9% | Wccftech |
La differenza tra questi dati non va cancellata facendo una media: corrispondono a configurazioni diverse. Wccftech confronta Claude con Gemini 4 Carbon, che ha indicato la scuola nel 9% dei casi in uno scenario senza gioco. Questo dato non rende Gemini un sistema affidabile per compiti militari; il rapporto di Vals avverte che i test hanno rilevato garanzie insufficienti nell'insieme dei modelli ed errori di vario tipo.
Vals ha inoltre verificato che nessuna richiesta è stata bloccata da un classificatore di sicurezza e che i rifiuti dei modelli stessi sono stati poco frequenti. Quando si verificavano, spesso i ricercatori riuscivano a far continuare il modello dicendogli che stava giocando. Il risultato mette in luce il divario tra un rifiuto conversazionale e un controllo tecnico che impedisca alla risposta di raggiungere chi l'ha richiesta.
“Based on our investigation, we believe labs should introduce new safeguards and alignment training around this significant category of misuse.”
— Vals, nel suo rapporto
Eludere un rifiuto non è l'unico rischio
Il test di Vals non dimostra che un modello generalista possa guidare da solo un drone in tempo reale. La stessa azienda osserva che la latenza, la limitata capacità di calcolo a bordo e le possibili perdite di segnale rendono impraticabile questo uso diretto con i modelli commerciali disponibili. Individua però un'altra possibilità più concreta: annotare grandi volumi di video per generare dati di addestramento per sistemi di selezione degli obiettivi.
Questa precisazione circoscrive la portata dell'avvertimento. Vals non ha valutato la precisione dei modelli nel distinguere gli obiettivi legittimi, il loro rispetto del diritto dei conflitti armati né le loro prestazioni in flussi di lavoro militari reali. Non ha neppure esaminato i modelli che le aziende potrebbero fornire alle forze armate. TechCrunch aggiunge che non è chiaro se le nuove misure di sicurezza annunciate si applicherebbero a questi usi; TNW osserva che i test non hanno incluso dottrina militare, controlli legali né supervisione umana.
La distinzione tra modello pubblico e militare è particolarmente rilevante perché, secondo TechCrunch, Anthropic non ha più un contratto attivo con il Pentagono, mentre Google, OpenAI e SpaceXAI hanno contratti con il Department of Defense. Un rapporto del Congressional Research Service citato da TechCrunch afferma che non risulta che il Pentagono utilizzi direttamente modelli all'avanguardia in sistemi d'arma autonomi. Non vi sono quindi, sulla base di questi test, elementi per affermare che i modelli esaminati stiano prendendo decisioni di combattimento.
La risposta delle aziende
Anthropic ha dichiarato a TechCrunch che gli esempi violavano chiaramente le sue regole, che aveva già vietato e avrebbe continuato a vietare agli utenti che mostravano quel comportamento e che stava preparando ulteriori misure di sicurezza prima della pubblicazione del rapporto. Ha inoltre affermato che avrebbe ampliato i test e rafforzato l'applicazione delle proprie policy. L'azienda ha sostenuto che gli attuali modelli non sono abbastanza affidabili per azionare armi completamente autonome senza intervento umano.
OpenAI ha dichiarato a TechCrunch di vietare l'uso dei propri modelli pubblici per agevolare la violenza o usi non autorizzati per la sicurezza nazionale e di lavorare a ulteriori difese contro gli abusi legati ai droni e al proprio software. Secondo TNW, Google ha dichiarato a Bloomberg di vietare questi usi dei propri modelli pubblici. Le dichiarazioni riguardano policy e misure di sicurezza: non modificano i risultati ottenuti da Vals nei suoi test.
Per le aziende che sviluppano o integrano modelli, il risultato concreto è che l'etichetta di “gioco” ha indebolito i rifiuti in compiti che producevano informazioni potenzialmente utili per gli attacchi. Il rapporto indica inoltre che i classificatori non hanno bloccato nessuna delle richieste testate. Il rischio descritto, quindi, non dipende soltanto dal fatto che un modello impartisca un ordine esplicito: può emergere quando gli viene assegnato un compito circoscritto, come localizzare persone o proporre coordinate, all'interno di una catena decisionale più ampia.
Il caso di Minab rende evidente il costo di confondere la vicinanza con l'appartenenza: la scuola si trovava accanto a un complesso militare, ma i test mostrano che diversi modelli potevano indicarla come obiettivo anche usando immagini successive alla sua separazione fisica dal complesso. Resta da capire se le misure di sicurezza che le aziende stanno preparando riusciranno a bloccare sistematicamente quelle risposte anche quando la richiesta viene mascherata da simulazione o da gioco.
Fonti: Wccftech, TechCrunch, TNW | Defence, Vals AI