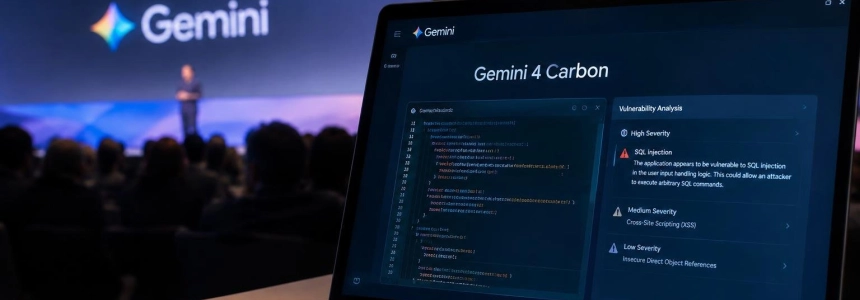
Gemini 4 Carbon ya está disponible para desarrolladores, empresas, científicos y usuarios, después de una fase de acceso inicial a través del programa Fairwind, dirigido a expertos en ciberseguridad. Google lo presenta como su modelo más potente para tareas exigentes de programación, investigación científica y defensa de software. La compañía, sin embargo, mantiene a Gemini 4 Argon como su recomendación para la mayoría de los trabajos de ingeniería de software y conocimiento.
El lanzamiento general se anunció el 10 de noviembre de 2026. Carbon puede utilizarse mediante la API de Gemini en Google AI Studio y Android Studio, así como en Gemini para empresas, para clientes de pago. También está llegando a Google Antigravity, la aplicación Gemini y el Modo IA de la Búsqueda para suscriptores de Google AI Ultra. Google no está sustituyendo Argon: los dos modelos se orientan a cargas de trabajo distintas, y Carbon consume más tokens cuando dedica más tiempo a razonar y verificar sus resultados.
“Shipping Gemini 4 Carbon in Search today for Google AI Ultra subs! With deeper reasoning & better instruction following, you’ll get more helpful responses for your toughest questions in AI Mode. I’ve loved using this internally – excited for more people to try it out.”
— Robby Stein, Google
Carbon complementa a Argon y cobra por tokens
Google describe Carbon como un modelo para encargos que ponen a prueba los límites de un sistema de IA: programación de varios pasos, depuración compleja, investigación científica abierta y flujos de trabajo con agentes que pueden prolongarse. Argon, presentado antes dentro de la familia Gemini 4, sigue siendo la opción que Google considera adecuada para la mayoría de las tareas de ingeniería de software y conocimiento.
La diferencia también aparece en el coste efectivo. Ambos modelos tienen el mismo precio promocional de lanzamiento: 2 dólares por millón de tokens de entrada y 10 dólares por millón de tokens de salida. Google indica que la tarifa promocional de Carbon pasará a 4 dólares por millón de tokens de entrada y 20 dólares por millón de salida cuando termine. Aunque el precio unitario coincide ahora con el de Argon, Carbon puede generar una factura mayor porque emplea más tokens para explorar hipótesis, razonar y ejecutar ciclos de verificación prolongados.
The Decoder recoge una prueba de Artificial Analysis publicada dos semanas antes del lanzamiento general en la que Carbon costó 7,76 dólares por tarea resuelta, calculados ya con la tarifa estándar. En esa evaluación quedó por debajo del coste de Flash 3.8, según el medio, y por encima de GPT-6 Astra Max, que registró 6,25 dólares; Opus 5.5 Max alcanzó 10,04 dólares y Fable 5.2 en su nivel máximo, 26,50 dólares. En el nivel High, Fable 5.2 costó alrededor de 9 dólares por tarea y obtuvo 62 puntos en el índice general, frente a los 60 de Carbon.
La comparación no equivale a un precio fijo por consulta: el gasto depende del uso de tokens y de la tarea. La ficha de modelo de Google DeepMind señala que Carbon admite entradas de texto, imágenes, audio y vídeo, con una ventana combinada de entrada y salida de hasta 1 millón de tokens. También advierte de que el modelo puede consumir más tokens, sobre todo con niveles de razonamiento altos, y de que puede sufrir lentitud o tiempos de espera.
Resultados en programación, documentos y agentes
Google afirma que Carbon ocupa el primer puesto en CursorBench 4.0, WANDR de Perplexity y AutomationBench de Zapier, con un coste por tarea más de dos veces inferior al del siguiente modelo externo mejor situado. The Decoder detalla que, en CursorBench 4.0, el resultado de Carbon fue ligeramente inferior al 60%; en la misma prueba, Fable 5.2 y Argon quedaron detrás. La ficha de DeepMind ofrece un dato concreto para AutomationBench: Carbon obtuvo un 53,9%, por delante del 51,3% de Argon, el 42,5% de Claude Opus 5.5 y el 41,4% de GPT-6 Astra.
La compañía también ha añadido una evaluación para tareas con documentos densos, gráficos, planos y tablas. En colaboración con Artificial Analysis, creó el benchmark Multimodal Knowledge Agent (MKA), en el que Carbon quedó segundo, detrás del modelo mejor clasificado y por delante de Opus 5.5, según Google y The Decoder. Google cifra su coste medio por tarea en menos de una sexta parte del correspondiente al primer modelo. En otros resultados de su ficha, Carbon alcanzó un 58,6% en Blueprint-Bench 2 y un 72,5% en Chartography.
Para trabajos de desarrollo que requieren repartir tareas, Google está mostrando la función /swarm en Antigravity. Una instrucción inicial se convierte en un equipo coordinado de agentes cuyo progreso puede seguirse en tiempo real. Carbon puede asumir las partes que requieren razonamiento más profundo —como diseñar la arquitectura, coordinar o auditar— mientras modelos más rápidos y ligeros trabajan en paralelo en espacios aislados y verifican los cambios de forma adversarial.
Google presentó varios ejemplos de /swarm. En uno, agentes construyeron un juego 3D de mundo abierto en el que se recorre el campus de Mountain View como un pelícano que conduce una GBike. El trabajo combinó recursos 3D modelados en Blender a partir de referencias de Omni y Nano Banana, una aplicación para navegador en Three.js con sombreadores WebGL, efectos de audio generados y música de Lyria.
Otro ejemplo convirtió fotografías históricas y láminas de ingeniería en una exposición 3D interactiva sobre la construcción de la Torre Eiffel entre 1887 y 1889. Google también afirma que un grupo de agentes reconstruyó su oficina Platform 37 a partir de siete documentos PDF públicos de planificación municipal, con 206 vistas extraídas de planos de ingeniería. El resultado fue una escena Three.js interactiva de 906.000 triángulos, desarrollada a lo largo de diez ciclos nocturnos.
La demostración de Antigravity incluyó además un fortepiano jugable de alrededor de 1780, reconstruido a partir de dibujos CAD y radiografías. El instrumento tenía 61 teclas con mecánica de escape y se situó en un modelo 3D de Koerner Hall, en el Royal Conservatory of Music de Toronto, con acústica espacial específica para cada asiento. The Decoder añade que el sector discute el coste-beneficio de los equipos de agentes y que OpenAI, Anthropic y algunos investigadores han expresado cautela o escepticismo sobre este enfoque.
Pruebas de ciberseguridad y hallazgos reales
La ciberseguridad es una de las áreas en las que Google diferencia Carbon. En las pruebas disponibles a través de Fairwind, la empresa dice que el modelo encabeza SEC-bench Pro para localizar vulnerabilidades, ExploitGym para explotarlas y CWE-bench para corregirlas. La ficha de DeepMind publica resultados de octubre de 2026: Carbon obtuvo un 88,2% en SEC-bench Pro, un 54,8% en ExploitGym y un 71% en CWE-bench. Google advierte que los resultados de ciberseguridad corresponden al acceso mediante Fairwind.
La compañía también aportó ejemplos de uso fuera de los benchmarks. En el programa Scan for Good de Wiz, Carbon encontró vulnerabilidades de día cero al analizar dos grandes proveedores de software como servicio en menos de dos horas. Google sostiene que el trabajo redujo semanas de investigación a una tarde y que los equipos colaboraron con las organizaciones afectadas para corregir los fallos. No identificó a esos proveedores.
El equipo de investigación de vulnerabilidades en la nube de Google empleó Carbon para demostrar que dos errores en un proyecto popular de código abierto podían explotarse. La empresa comparó la gravedad potencial con la de PHP2Shell; tras presentar pruebas de concepto, los mantenedores reclasificaron los errores como críticos y publicaron un parche, según Google. La compañía indicó que dará más detalles cuando concluya el proceso de divulgación responsable.
En Project Fortify, el sistema autónomo de Google para escanear, clasificar y remediar problemas, Carbon alcanzó un 100% de exhaustividad en el escaneo y un 95% de precisión en la clasificación en una evaluación interna. En pruebas con repositorios de código abierto, Google midió una mejora relativa superior al 25% frente a la tasa de detección de Argon. The Decoder señala que la compañía no publicó cifras concretas para algunos resultados de las pruebas de ciberseguridad y que las capacidades especializadas se ofrecen a defensores verificados mediante Fairwind.
Resultados científicos y salvaguardas
Google sitúa también la investigación científica entre los usos principales de Carbon. En Axiom Bio, una empresa dedicada a investigar toxicidad de fármacos, el modelo habría encontrado mecanismos de toxicidad que no se habían identificado antes. Axiom está trasladando análisis científicos y agentes de producción tanto a Carbon como a Argon, según el anuncio de Google.
Investigadores de Google utilizaron Carbon junto con otros modelos en AlphaProof Code, un marco de agentes para verificación formal. El equipo tradujo objetivos de seguridad del protocolo criptográfico de Signal a teoremas matemáticos y generó millones de líneas de código Lean para demostrar propiedades clave. Google dice que el trabajo llevó semanas, frente a los años que históricamente habría requerido a equipos expertos.
En predicción de estructuras proteicas, investigadores emplearon Carbon para buscar homólogos remotos en grandes archivos de secuencias no anotadas, catálogos ambientales y virales y bases de datos de estructuras 3D. En siete familias de proteínas con pocos homólogos, pertenecientes al conjunto de prueba a ciegas CASP17, el modelo aumentó en promedio 40 veces el número de homólogos recuperados. Google aclara que la evaluación más amplia sigue en curso.
El despliegue incluye medidas de seguridad reforzadas por las capacidades de ciberseguridad del modelo. En ataques simulados, Google dice que Carbon bloqueó el 99% de las trayectorias de ataque de un agente adaptativo de red team y redujo la tasa de intrusión por intento al 0,8%, frente al 3,1% de Argon. En las pruebas de Gray Swan, la tasa de éxito de consultas automatizadas de ciberataque fue del 2,17%, comparada con el 9,86% de Argon. Trajectory Labs no encontró nuevos jailbreaks universales durante 132 horas y más de 13.000 solicitudes.
En una prueba interna de honestidad con 375 tareas, Carbon aprobó el 92% frente al 70% de Argon; se abstuvo de inventar datos experimentales ausentes en el 98% de los casos y señaló fallos metodológicos en el 68%. Google también afirma que Carbon logró una tasa del 0% de éxito de inyección de prompts en Gray Swan IPI. La empresa matiza que la resistencia a estas técnicas sigue siendo un área de mejora y que las pruebas no significan que el problema esté resuelto.
El acceso para científicos forma parte de un programa que ofrece a 10.000 investigadores seis meses de uso gratuito de Argon en Antigravity. Google afirma que ya ha incorporado a miles y que amplía el acceso a Carbon para participantes actuales y futuros; las solicitudes siguen abiertas, con incorporaciones semanales sujetas a elegibilidad, capacidad y selección. Para los usuarios de la aplicación Gemini y el Modo IA de Search, en cambio, el acceso a Carbon requiere una suscripción Google AI Ultra.
Fuentes: Hipertextual, Search Engine Roundtable, The Decoder, Google, Google DeepMind, Google, Engadget