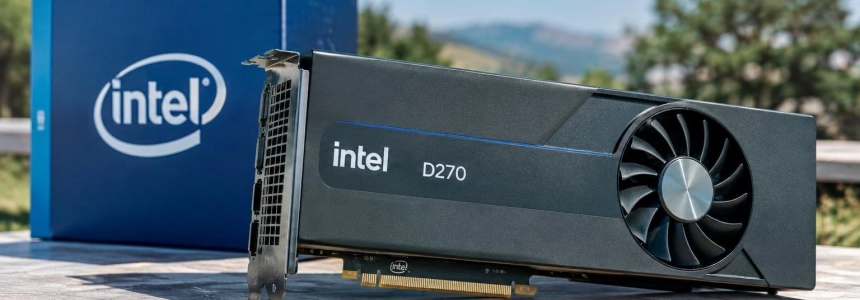
Intel atribuye a su GPU D270, conocida durante su desarrollo como Crescent Island, hasta 5,9 veces más rendimiento que a la RTX PRO 6000 Blackwell Server Edition en una prueba financiera de doble precisión. La compañía presentó sus primeros resultados en SC26 y sostiene que el acelerador, concebido para inferencia de inteligencia artificial, también puede abordar cargas de computación de alto rendimiento (HPC).
El argumento técnico central es el soporte nativo para operaciones FP64 a velocidad completa, una capacidad que Intel presenta como adecuada para simulaciones científicas, ingeniería y finanzas. La comparación publicada enfrenta la D270 con la tarjeta de NVIDIA, cuyo consumo indicado es de 600 vatios frente a 350 en la solución de Intel.
Cuatro pruebas financieras, con una ventaja desigual
Los resultados de Intel abarcan cuatro aplicaciones para cálculos financieros. La mayor diferencia aparece en European Monte Carlo; en Black-Scholes americano, la ventaja declarada es menor. Consideradas en conjunto, las pruebas arrojan una media de aproximadamente 4,5 veces más rendimiento para la D270, según la compañía.
| Prueba | Ventaja declarada de D270 |
|---|---|
| European Monte Carlo | 5,9 veces |
| Black-Scholes europeo | 5,6 veces |
| Modelo binomial | 4,6 veces |
| Black-Scholes americano | 1,92 veces |
La comparación es de Intel y se realizó con silicio todavía en fase de preproducción. StorageReview añade que la configuración de las pruebas financieras enumera ocho tarjetas de NVIDIA frente a una D270, pero no especifica si normaliza los resultados por tarjeta. Por tanto, las cifras publicadas no bastan por sí solas para despejar cómo se comparan ambas plataformas en configuraciones equivalentes.
La elección de FP64 diferencia a la D270 de muchos aceleradores enfocados en inferencia. Esa precisión de doble punto flotante permite que la tarjeta cubra cargas que, según Intel, necesitan mantener exactitud numérica durante cálculos repetidos. La arquitectura también admite niveles de precisión inferiores, desde FP4 hasta FP8, para priorizar el rendimiento de inferencia.
Xe3P, XMX y una configuración de 160 GB
La D270 se basa en Xe3P e integra 32 núcleos Xe y 256 motores XMX. Intel indica que cada núcleo puede ejecutar 64 operaciones FP64 fused multiply-add (FMA). La combinación permite alternar entre formatos de baja precisión para IA y FP64 para trabajos que requieren mayor precisión matemática.
La tarjeta de referencia incluye 160 GB de LPDDR5X, con un ancho de banda declarado de 1,5 TB/s. Las configuraciones diseñadas por socios pueden elevar la capacidad hasta 480 GB. Intel plantea esa memoria como una forma de mantener conjuntos de datos extensos en la GPU y reducir los traslados entre el acelerador y el sistema anfitrión.
El modelo estándar está diseñado para consumir 350 W, usar refrigeración por aire y conectarse mediante PCIe 5.0. Intel también prevé configuraciones con refrigeración líquida y sistemas de dos GPU, aunque no ha dado detalles comerciales de esas variantes. La capacidad de memoria y las distintas opciones de refrigeración forman parte de la propuesta para servidores de IA y HPC.
LPDDR5X es una elección distinta de las memorias GDDR y HBM habituales en aceleradores de este tipo. Intel la presenta como un equilibrio entre capacidad, consumo y coste, pero todavía no ha publicado un precio para la D270 ni para sus configuraciones de socios.
Una demostración sísmica con software migrado a SYCL
En SC26, Intel también mostró una aplicación de imagen sísmica desarrollada junto a Veridien. Este tipo de carga, vinculada a la industria petrolera y energética, calcula repetidamente la propagación de ondas acústicas sobre grandes conjuntos de datos tridimensionales y utiliza principalmente FP32.
La demostración mantiene grandes matrices de campos de onda en la memoria de la tarjeta y emplea optimizaciones de stencil que reutilizan datos en las cachés locales. Intel indicó que Veridien migró a SYCL una aplicación previamente escrita para HIP y CUDA en menos de un mes, sin modificar el código ejecutado en la CPU.
Según Intel, cerca del 90 % de los kernels funcionó de manera satisfactoria sin optimizaciones específicas para su hardware. Los kernels más complejos alcanzaron hasta el 70 % del rendimiento teórico máximo en su primera versión sin optimizar. La compañía también afirmó que se validaron tanto la precisión numérica como el rendimiento.
Profesional Review y StorageReview describen otra demostración del stand: un flujo de inferencia repartido entre las GPU D270 y los procesadores SN50 de SambaNova, con Xeon 6 y Xeon 6+ coordinando el sistema. En esa configuración, las D270 se ocupan del procesamiento inicial de la petición y los SN50 generan la respuesta.
Resultados de inferencia para modelos de decisión y lenguaje
Las cifras de IA de Intel comparan también la D270 con la RTX PRO 6000 Blackwell Server Edition. Para Drex 2.0, descrito como un modelo de toma de decisiones, Intel declara hasta un 29 % menos de latencia. En la prueba de rendimiento con Qwen 3 30B-A3B, afirma haber logrado 1,12 veces el throughput de la tarjeta de NVIDIA; Profesional Review especifica que esa medición se hizo en FP8.
Intel vincula estos resultados con cargas de IA agéntica: modelos que pueden encadenar razonamiento, recuperación de información, uso de herramientas y llamadas a otros modelos. Entre los usos que menciona están la generación aumentada por recuperación (RAG) con contextos largos, los asistentes empresariales, las herramientas de programación, la comprensión de documentos y los modelos multimodales y de difusión.
La D270 no se plantea, por tanto, como una GPU exclusivamente dedicada al HPC. Intel la describe ante todo como un acelerador de inferencia para centros de datos, y sostiene que su memoria y su variedad de precisiones también permiten abordar trabajos científicos y financieros.
“abierto, heterogéneo y equilibrado”
— Jeff McVeigh, vicepresidente y director general de Data Center Strategic Programs de Intel, citado por StorageReview
El software abierto, parte de la estrategia de Intel
Intel quiere que la adopción de la D270 no obligue a reconstruir desde cero aplicaciones existentes ni a depender de un entorno propietario. Su planteamiento combina SYCL para programación de GPU con integración en frameworks y runtimes de IA, además de inversiones en Intel MPI, compiladores Fortran y herramientas de C++ de alto rendimiento.
La demostración de Veridien sirve como ejemplo concreto de esa apuesta: el port desde HIP y CUDA a SYCL se completó en menos de un mes, de acuerdo con Intel. La empresa también apunta a sistemas en los que CPU y aceleradores reparten tareas de HPC e IA, con los procesadores coordinando flujos mientras las GPU asumen parte del cálculo.
SC26 es el escenario elegido para enseñar estas capacidades y publicar las primeras comparaciones. Sin embargo, los datos siguen siendo resultados del fabricante sobre silicio de preproducción; StorageReview señala además que no auditó ni reprodujo los benchmarks y que las pruebas de inferencia de NVIDIA utilizaron una máquina virtual de AWS.
Precio y lanzamiento pendientes
Intel no ha fijado una fecha de disponibilidad comercial ni un precio para la D270. Esos dos datos siguen pendientes mientras la compañía presenta la tarjeta como una opción común para inferencia, HPC y cargas de trabajo que combinan ambas áreas.
Fuentes: Hardware Upgrade, Wccftech, Profesional Review, StorageReview.com