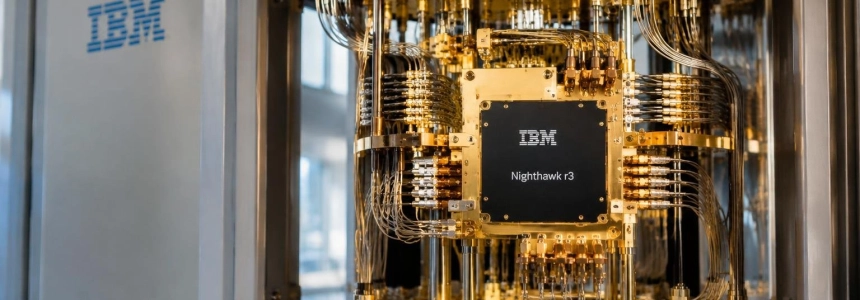
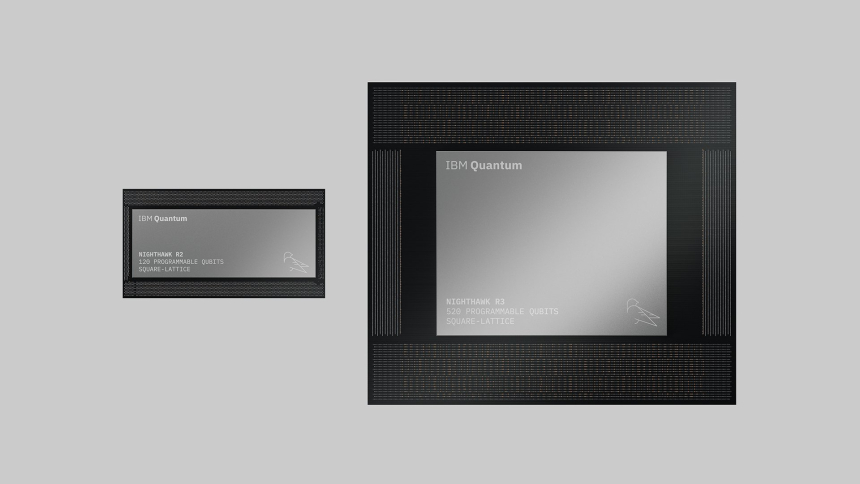
IBM ha presentado Nighthawk r3, con 520 cúbits programables, un procesador diseñado para ejecutar con precisión 10.000 operaciones cuánticas. La compañía planea conectar dos unidades en 2027 para formar un sistema de 1.040 cúbits, con el objetivo de abordar cálculos de mayor tamaño sin perder la velocidad de la generación actual de Nighthawk.
El anuncio de IBM, fechado el 11 de noviembre, presenta r3 como la siguiente generación de Nighthawk. La compañía sostiene que el procesador conserva la rapidez y la calidad demostradas por la generación actual, mientras amplía la escala del hardware. El diseño mantiene la conectividad en cuadrícula y las operaciones rápidas de r2, y añade conexiones para enlazar procesadores en sistemas más grandes.
Hay una diferencia en la descripción de la capacidad: IBM especifica 520 cúbits programables, cifra que también recoge StorageReview. Europa Press, en el cuerpo de su noticia, dice que r3 está diseñado para 10.000 operaciones en 250 cúbits, aunque el titular de esa pieza menciona 520. IBM informa además de 2.034 cúbits físicos en el procesador.
Diez enlaces entre chips y un plan de escala
La novedad de arquitectura son 10 interconexiones entre chips, que IBM denomina l-couplers. Están pensadas para enlazar procesadores y extender el sistema más allá de un único chip. La hoja de ruta anunciada fija para 2027 la conexión de dos Nighthawk r3 en una máquina de 1.040 cúbits.
La empresa ya había probado parte de esta estrategia con Nighthawk r1: este año conectó dos procesadores mediante cuatro l-couplers. IBM comunicó una fidelidad media de transferencia de estado cuántico del 99 por ciento y un mejor resultado del 99,3 por ciento, frente a un objetivo del 99,9 por ciento. La prueba sirve como antecedente para la interconexión modular, pero no constituye todavía el sistema r3 previsto.
IBM también informó de que unió por primera vez dos módulos criogénicos en un solo sistema. El conjunto alcanzó la temperatura de funcionamiento en menos de cinco días y se enfrió por debajo de 15 milikelvin. La compañía vincula estos avances —interconexión y refrigeración modular— con su plan para construir sistemas cuánticos mayores.
| Procesador o sistema | Datos comunicados |
|---|---|
| Nighthawk r2 | 120 cúbits programables, 458 físicos, más de 7.500 operaciones y hasta 100.000 muestras por segundo. |
| Nighthawk r3 | 520 cúbits programables, 2.034 físicos, 10.000 operaciones y 10 l-couplers. |
| Sistema planeado para 2027 | Dos procesadores r3 conectados, con un total de 1.040 cúbits. |
La diferencia de escala entre r2 y r3 es marcada: el modelo anterior trabaja con 120 cúbits programables y el nuevo, según IBM, con 520. La compañía describe r3 como una ampliación de la arquitectura rápida de r2, no como un cambio de enfoque. No ha anunciado en estas comunicaciones una fecha de disponibilidad para r3 distinta del plan de conexión de dos unidades en 2027.
La velocidad de r2, en pruebas de clientes y socios
El antecedente inmediato es Nighthawk r2, presentado en septiembre. IBM afirma que ofrece hasta 100.000 muestras por segundo y admite cálculos precisos con más de 7.500 operaciones en 120 cúbits. Su tecnología de reinicio rápido reduce el intervalo entre ejecuciones de circuitos, lo que permite recopilar las millones o miles de millones de muestras que algunas aplicaciones necesitan.
Según IBM, E.ON, Algorithmiq y Q-CTRL han ejecutado en conjunto 34.000 millones de circuitos en r2, con mejoras de rendimiento de hasta 19 veces y manteniendo la calidad requerida para cálculos científicos. La empresa también cita a Quantum Elements y ParityQC entre los socios que han comunicado mejoras en sus propias cargas de trabajo.
Entre los resultados concretos, E.ON informó de una aceleración de 15 veces en una tarea de aprendizaje automático cuántico para optimizar redes energéticas. IBM, por su parte, obtuvo una mejora de 12 veces en un experimento realizado con Oak Ridge National Laboratory para simular materiales magnéticos reales; los resultados fueron consistentes con experimentos de dispersión de neutrones. Ambas comparaciones se hicieron frente a trabajos anteriores con IBM Quantum Heron.
IBM también señala que un experimento de Algorithmiq sobre un material cuántico heterogéneo se ejecutó ocho veces más rápido en r2 que en Heron. Para alcanzar una precisión comparable, los métodos clásicos de redes tensoriales necesitarían, según la estimación de IBM, 240 veces más memoria que en la implementación original. IBM indica que los circuitos y resultados de los experimentos de ventaja cuántica publicados en julio están disponibles para pruebas independientes mediante Quantum Advantage Tracker, una iniciativa liderada por la comunidad.
“Useful quantum computing hinges on whether results can be delivered with accuracy and speed, both are fundamental,”
— Jay Gambetta, director de IBM Research e IBM Fellow
IBM integra los cálculos clásicos con los cuánticos
La estrategia no se limita al procesador. IBM está reuniendo computación cuántica y computación clásica de alto rendimiento (HPC) en un entorno gestionado, IBM Quantum Platform. Los usuarios pueden integrar flujos de trabajo cuánticos con recursos clásicos que van desde un portátil hasta una supercomputadora, además de los recursos HPC y clásicos que ahora ofrece la plataforma.
La integración responde, según IBM, a las necesidades de cargas de trabajo que combinan corrección y mitigación de errores cuánticos, aprendizaje del ruido y posprocesamiento clásico. Para dar a los investigadores más control, la plataforma también ofrece funciones de nivel de pulso, con las que pueden ajustar operaciones, reiniciar cúbits con mayor rapidez y extraer más información de las mediciones.
IBM comunicó dos ejemplos de uso de este entorno. Sus científicos y los de RIKEN ejecutaron un flujo de diagonalización cuántica basada en muestras aproximadamente cinco veces más rápido y realizaron 100 veces más cálculos que en el estudio original. Cleveland Clinic y RIKEN procesaron automáticamente 608 millones de muestras para modelar estructuras biológicamente relevantes, 33 veces más rápido que sin automatización del flujo de trabajo.
La empresa también ha creado una plataforma de codesarrollo para investigar corrección de errores cuánticos junto con Oak Ridge National Laboratory y AMD. El sistema sitúa Nighthawk junto a Umbra, el sistema HPC de Oak Ridge, equipado con GPU AMD Instinct MI355X y CPU AMD EPYC de quinta generación. El propósito anunciado es diseñar algoritmos de corrección de errores que aprovechen recursos cuánticos y clásicos de forma conjunta.
De Nighthawk a Starling, el objetivo de 2029
La conexión de dos r3 en 2027 forma parte de una hoja de ruta más amplia. IBM prevé que Starling llegue en 2029 como su primer ordenador cuántico tolerante a fallos. La compañía relaciona ese proyecto con circuitos de hasta 100 millones de operaciones y con una arquitectura modular que necesitará más de 100 interconexiones l-coupler trabajando coordinadamente.
En una publicación de IBM Quantum para su conferencia de desarrolladores de 2026, la empresa describió Starling como un sistema que deberá ejecutar circuitos útiles en minutos, en lugar de meses. La misma publicación detalla trabajos paralelos en componentes como memoria, decodificadores, interconexiones, criogenia y electrónica de control. En ese contexto, r3 y sus enlaces entre chips son un paso dentro de una transición que IBM plantea hacia máquinas mayores, no la llegada de un sistema tolerante a fallos.
IBM presentó Nighthawk r3 el 11 de noviembre y prevé que la siguiente demostración de escala sea la unión de dos procesadores en 2027. La fecha de disponibilidad del procesador individual no figura en el anuncio; el hito fechado es el sistema combinado de 1.040 cúbits.
Fuentes: europapress.es, IBM Newsroom, IBM Quantum, StorageReview