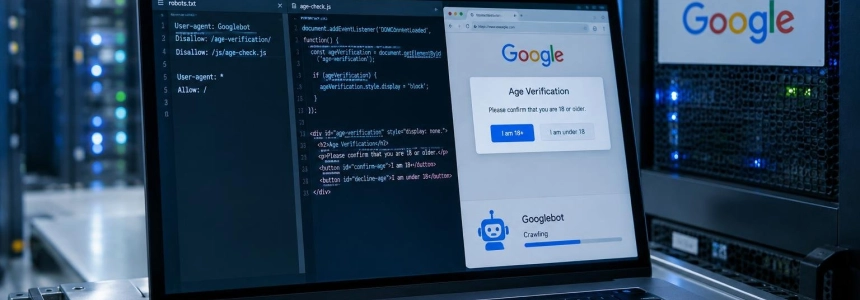
Googlebot puede dejar de renderizar una ventana de verificación de edad si el recurso que la muestra queda bloqueado mediante robots.txt. John Mueller, de Google, explicó en Reddit dos formas de hacerlo: impedir el rastreo del dominio externo que sirve la ventana o bloquear el archivo JavaScript que la carga desde el propio sitio. La condición es que la página siga cargando correctamente cuando el robot no pueda obtener esos recursos.
La aclaración responde a una pregunta sobre un sitio hipotético que incorpora mediante una API una ventana emergente alojada en otro dominio. La consulta planteaba si una regla disallow en el robots.txt de ese dominio externo evitaría que Google viera el aviso, que los visitantes humanos sí deben mostrar por motivos legales. Mueller respondió que, en general, sí.
Dos formas de impedir que Googlebot cargue la ventana
La primera opción es actuar en el dominio que aloja el contenido incrustado. Si el proveedor de la ventana bloquea el rastreo en su robots.txt, Googlebot no obtiene esos recursos y no puede utilizarlos al renderizar la página. Esto puede ocurrir tanto si el contenido se incorpora mediante un iframe como si la página llama a un script alojado en el dominio externo.
Mueller señaló que el mecanismo también se ve en servicios de publicidad: Googlebot puede intentar solicitar los recursos durante el renderizado, aunque no los rastree como páginas independientes. Si robots.txt impide la solicitud, el contenido no está disponible para esa representación. En el caso de la ventana de edad, el efecto buscado sería que el robot no la cargue.
La otra alternativa es bloquear desde el sitio propio el archivo concreto que inserta la ventana. Mueller usó como ejemplo un script dedicado, con un nombre como load-verification-popup.js. Al desautorizar ese archivo en el robots.txt del sitio, el script no se carga durante el renderizado. Según explicó, esta vía resulta menos habitual y sería necesaria si el propietario del sitio no puede modificar el robots.txt del dominio externo.
“That would generally work. If you’re using a specific JS script file to do this, you could also disallow that specific javascript file via robots.txt. (If you only have one JS file that does a bunch of things, I wouldn’t do that”
— John Mueller, Google
La advertencia se refiere a los archivos que hacen más de una tarea. Si el mismo JavaScript controla otras funciones de la página además de mostrar el aviso, bloquearlo puede impedir que Googlebot obtenga recursos necesarios para renderizarla. La recomendación de Mueller se limita al script específico que carga la ventana; su respuesta no avala bloquear indiscriminadamente archivos compartidos.
La página debe funcionar sin el recurso bloqueado
En su explicación posterior, Mueller subrayó que el sitio debe seguir cargando cuando Googlebot no pueda acceder a los recursos bloqueados. Para una ventana emergente como la de verificación de edad, indicó que normalmente esto no debería ser un problema. La distinción práctica es entre retirar del renderizado un elemento aislado y bloquear un recurso del que dependen otras partes de la página.
Por tanto, el hecho de que una ventana sea visible para los usuarios no obliga, en este caso concreto, a que Googlebot pueda descargarla. Pero el planteamiento depende de que el contenido restante siga disponible y de que la regla afecte al recurso adecuado. Si el sitio bloquea un archivo JavaScript que también sirve para otras funciones, el renderizado puede quedar incompleto.
La pregunta publicada en Reddit describía un escenario hipotético: un sitio llamado websiteA.com mostraba por razones legales una ventana alojada en verificationpopup.com, insertada mediante una API. Quien preguntó quería saber si una directiva disallow en el archivo robots.txt de verificationpopup.com evitaría que Google renderizara el aviso. Mueller contestó primero que normalmente funcionaría y después detalló las dos ubicaciones donde se puede aplicar el bloqueo.
El contexto: de desbloquear recursos a permitir excepciones
La consulta tiene como telón de fondo un cambio en las prácticas de rastreo. En los primeros años del SEO, algunos profesionales bloqueaban JavaScript y CSS para reducir el consumo de presupuesto de rastreo y facilitar la indexación. Más adelante, cuando Google empezó a renderizar páginas, pidió a los propietarios que permitieran a Googlebot descargar los recursos que los usuarios podían ver.
Según el contexto recogido por Search Engine Journal y SERP Journal, algunos sitios que mantuvieron bloqueados recursos importantes perdieron posiciones temporalmente durante aquella transición. Esa historia explica por qué la pregunta sobre una ventana legalmente obligatoria no era trivial: la instrucción general de permitir recursos visibles podía parecer incompatible con ocultar deliberadamente un elemento al robot.
La respuesta de Mueller acota el caso. No presenta el bloqueo como una regla general para ocultar contenido de Google, sino como una posibilidad técnica para recursos concretos, siempre que el sitio siga renderizando. SERP Journal destaca, además, la cautela sobre los scripts que realizan varias tareas. Brandon Lazovic también resume el consejo como una opción para bloquear el dominio del popup o el archivo que lo carga, con la misma condición sobre el funcionamiento de la página.
robots.txt no garantiza que una URL desaparezca de Google
La documentación de Google para desarrolladores distingue entre bloquear el rastreo de una URL y evitar que aparezca en los resultados. robots.txt indica a los rastreadores qué direcciones pueden solicitar y se utiliza principalmente para gestionar el tráfico. No es un mecanismo diseñado para impedir que una página se muestre en Google.
Google explica que una URL bloqueada puede seguir apareciendo en los resultados si otros sitios enlazan a ella, aunque el buscador no haya rastreado su contenido. Para impedir que una página aparezca, la documentación recomienda usar noindex o protegerla con contraseña, según el caso. Esa limitación es distinta de la cuestión de Mueller: aquí se trata de que Googlebot no obtenga un recurso durante el renderizado, no de retirar una URL de los resultados.
La documentación también permite bloquear recursos —como imágenes, scripts o archivos de estilo— cuando prescindir de ellos no perjudique de forma significativa la página. Advierte que no se deben bloquear si eso dificulta el análisis que Google hace de páginas dependientes de esos recursos. Y recuerda que las reglas de robots.txt las siguen los rastreadores fiables, pero no obligan a todos los robots de la web a respetarlas.
La respuesta de Mueller confirma que una ventana emergente puede quedar fuera del renderizado de Googlebot mediante una regla en el dominio que la sirve o mediante el bloqueo de su script dedicado. La duda que queda abierta es si Google incorporará esta tolerancia selectiva a una guía oficial más amplia; SERP Journal plantea esa posibilidad como un asunto a seguir, no como un cambio ya anunciado.
Fuentes: Search Engine Journal, Google for Developers, SERP Journal, Brandon Lazovic