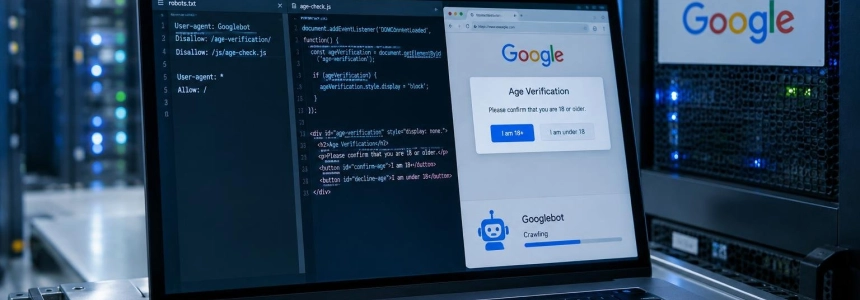
Googlebot può smettere di renderizzare una finestra di verifica dell’età se la risorsa che la mostra viene bloccata tramite robots.txt. John Mueller di Google ha spiegato su Reddit due modi per farlo: impedire la scansione del dominio esterno che fornisce la finestra oppure bloccare il file JavaScript che la carica dal sito stesso. La condizione è che la pagina continui a caricarsi correttamente quando il robot non può accedere a queste risorse.
Il chiarimento risponde a una domanda su un sito ipotetico che incorpora tramite un’API una finestra pop-up ospitata su un altro dominio. La domanda chiedeva se una regola disallow nel robots.txt di quel dominio esterno impedirebbe a Google di vedere l’avviso, che deve invece essere mostrato ai visitatori umani per motivi legali. Mueller ha risposto che, in generale, sì.
Due modi per impedire a Googlebot di caricare la finestra
La prima opzione consiste nell’intervenire sul dominio che ospita il contenuto incorporato. Se il fornitore della finestra blocca la scansione nel proprio robots.txt, Googlebot non ottiene quelle risorse e non può utilizzarle per renderizzare la pagina. Questo può accadere sia quando il contenuto viene incorporato tramite un iframe, sia quando la pagina richiama uno script ospitato sul dominio esterno.
Mueller ha osservato che questo meccanismo si riscontra anche nei servizi pubblicitari: Googlebot può tentare di richiedere le risorse durante il rendering, anche se non le scansiona come pagine indipendenti. Se robots.txt impedisce la richiesta, il contenuto non è disponibile per quella rappresentazione. Nel caso della finestra di verifica dell’età, l’effetto desiderato sarebbe che il robot non la caricasse.
L’altra alternativa consiste nel bloccare dal proprio sito il file specifico che inserisce la finestra. Mueller ha fatto l’esempio di uno script dedicato, con un nome come load-verification-popup.js. Impedendo la scansione di quel file nel robots.txt del sito, lo script non viene caricato durante il rendering. Come ha spiegato, questa soluzione è meno comune e sarebbe necessaria se il proprietario del sito non potesse modificare il robots.txt del dominio esterno.
“That would generally work. If you’re using a specific JS script file to do this, you could also disallow that specific javascript file via robots.txt. (If you only have one JS file that does a bunch of things, I wouldn’t do that”
— John Mueller, Google
L’avvertenza riguarda i file che svolgono più di una funzione. Se lo stesso JavaScript gestisce altre funzionalità della pagina oltre a mostrare l’avviso, bloccarlo può impedire a Googlebot di ottenere le risorse necessarie per renderizzarla. Il consiglio di Mueller si limita allo script specifico che carica la finestra; la sua risposta non avalla il blocco indiscriminato di file condivisi.
La pagina deve funzionare senza la risorsa bloccata
Nella sua spiegazione successiva, Mueller ha sottolineato che il sito deve continuare a caricarsi quando Googlebot non può accedere alle risorse bloccate. Per una finestra pop-up come quella di verifica dell’età, ha indicato che normalmente non dovrebbe essere un problema. La distinzione pratica è tra escludere dal rendering un elemento isolato e bloccare una risorsa da cui dipendono altre parti della pagina.
Pertanto, il fatto che una finestra sia visibile agli utenti non implica, in questo caso specifico, che Googlebot debba poterla scaricare. Tuttavia, l’approccio dipende dal fatto che il resto dei contenuti rimanga disponibile e che la regola riguardi la risorsa corretta. Se il sito blocca un file JavaScript utilizzato anche per altre funzioni, il rendering potrebbe risultare incompleto.
La domanda pubblicata su Reddit descriveva uno scenario ipotetico: un sito chiamato websiteA.com mostrava per motivi legali una finestra ospitata su verificationpopup.com, inserita tramite un’API. Chi ha posto la domanda voleva sapere se una direttiva disallow nel file robots.txt di verificationpopup.com avrebbe impedito a Google di renderizzare l’avviso. Mueller ha risposto inizialmente che in genere avrebbe funzionato, per poi illustrare le due posizioni in cui è possibile applicare il blocco.
Il contesto: dallo sblocco delle risorse alle eccezioni
La domanda si inserisce in un cambiamento nelle pratiche di scansione. Nei primi anni della SEO, alcuni professionisti bloccavano JavaScript e CSS per ridurre il consumo del budget di scansione e facilitare l’indicizzazione. In seguito, quando Google ha iniziato a renderizzare le pagine, ha chiesto ai proprietari dei siti di consentire a Googlebot di scaricare le risorse visibili agli utenti.
Secondo il contesto riportato da Search Engine Journal e SERP Journal, alcuni siti che avevano continuato a bloccare risorse importanti hanno perso temporaneamente posizioni durante quella transizione. Questa storia spiega perché la domanda su una finestra obbligatoria per legge non fosse banale: l’indicazione generale di consentire le risorse visibili poteva sembrare incompatibile con il nascondere deliberatamente un elemento al robot.
La risposta di Mueller circoscrive il caso. Non presenta il blocco come una regola generale per nascondere contenuti a Google, ma come una possibilità tecnica per risorse specifiche, a condizione che il sito continui a essere renderizzato. SERP Journal sottolinea inoltre la cautela relativa agli script che svolgono più funzioni. Anche Brandon Lazovic riassume il consiglio come un’opzione per bloccare il dominio del pop-up o il file che lo carica, con la stessa condizione sul funzionamento della pagina.
robots.txt non garantisce che un URL scompaia da Google
La documentazione per sviluppatori di Google distingue tra bloccare la scansione di un URL e impedirne la comparsa nei risultati. robots.txt indica ai crawler quali indirizzi possono richiedere e viene utilizzato principalmente per gestire il traffico. Non è un meccanismo progettato per impedire che una pagina venga mostrata su Google.
Google spiega che un URL bloccato può continuare a comparire nei risultati se altri siti vi rimandano, anche se il motore di ricerca non ne ha scansionato i contenuti. Per impedire che una pagina venga mostrata, la documentazione consiglia di usare noindex o di proteggerla con una password, a seconda dei casi. Questa limitazione è diversa dalla questione sollevata da Mueller: qui si tratta di impedire a Googlebot di ottenere una risorsa durante il rendering, non di rimuovere un URL dai risultati.
La documentazione consente anche di bloccare risorse, come immagini, script o fogli di stile, quando farne a meno non danneggia significativamente la pagina. Avverte di non bloccarle se ciò ostacola l’analisi che Google effettua delle pagine che dipendono da tali risorse. Ricorda inoltre che le regole di robots.txt vengono rispettate dai crawler affidabili, ma non obbligano tutti i robot del web a seguirle.
La risposta di Mueller conferma che una finestra pop-up può essere esclusa dal rendering di Googlebot tramite una regola sul dominio che la fornisce oppure bloccando il suo script dedicato. Resta da capire se Google integrerà questa tolleranza selettiva in una guida ufficiale più ampia; SERP Journal presenta questa possibilità come un aspetto da seguire, non come un cambiamento già annunciato.
Fonti: Search Engine Journal, Google for Developers, SERP Journal, Brandon Lazovic