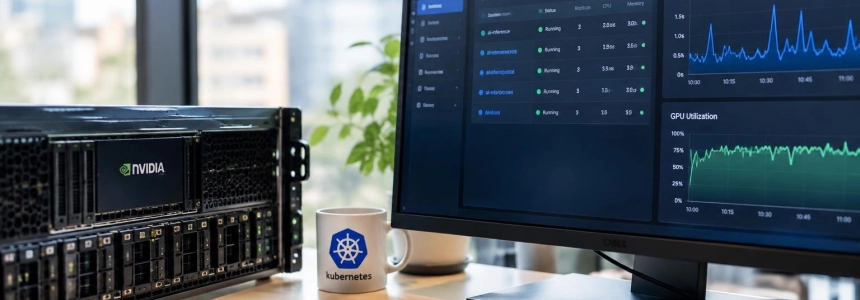
Una GPU al 100% puede ser una señal de saturación, no de éxito. En una aplicación de IA sobre Kubernetes, el clúster puede aparecer sano mientras los usuarios esperan demasiado para recibir una respuesta, o reciben una respuesta rápida pero equivocada. El reto consiste en conectar lo que experimenta el usuario con el modelo, los pods y los recursos de cómputo, almacenamiento y red.
Ese es el problema que plantea The New Stack en un artículo sobre inferencia y observabilidad, con aportaciones de Marius Bogoevici, Mahesh Ramachandran y Karthik Subramanian, de HPE. Su argumento central es práctico: la actividad del acelerador, por sí sola, no dice si el servicio cumple lo que la empresa necesita. Hay que medirlo antes de producción y contrastar después el comportamiento real con esa referencia.
“A quick first token can mask slow subsequent generation; a fast complete response can still be inaccurate or unhelpful.”
— Marius Bogoevici, Senior Principal Product Manager for HPE Morpheus Software
La primera respuesta no cuenta toda la historia
En un servicio conversacional, el tiempo hasta el primer token (TTFT) mide cuánto tarda en aparecer el comienzo de la respuesta. El tiempo hasta completar la petición, en cambio, incluye la generación del resto. Entre ambos, la latencia entre tokens —también llamada tiempo por token de salida— ayuda a observar el ritmo de generación una vez que el modelo ya ha empezado a contestar.
NVIDIA define el TTFT desde el envío de la consulta hasta la recepción del primer token. Ese intervalo puede incluir la espera en cola, el procesamiento inicial del prompt y la latencia de red. La latencia de extremo a extremo mide el tiempo hasta recibir la respuesta completa e incluye, entre otros componentes, la cola, el batching y la red. Son medidas distintas, no variantes intercambiables de una misma cifra.
La longitud de la entrada también importa. NVIDIA señala que un prompt más largo puede elevar el TTFT porque el modelo debe procesar la secuencia de entrada antes de empezar a generar. Una medición que solo observe el primer token puede pasar por alto una generación posterior lenta; una que solo calcule el tiempo total puede ocultar si el usuario tuvo que esperar demasiado antes de ver cualquier resultado.
Por eso, Bogoevici recomienda combinar medidas de latencia con fiabilidad, capacidad, eficiencia de recursos, coste y calidad de las respuestas. No todas las aplicaciones necesitan los mismos objetivos: la combinación adecuada depende de la experiencia que el equipo pretende ofrecer. El criterio no debería ser un número aislado, sino si el servicio cumple los objetivos fijados para su uso concreto.
Una línea base antes del tráfico real
Mahesh Ramachandran propone perfilar el sistema de inferencia antes de que dependan de él los clientes. Las pruebas deberían reproducir longitudes representativas de prompts y contexto, volúmenes de salida y niveles de tráfico. En esas condiciones, los equipos pueden registrar latencia, tokens procesados y medidas de servicio, y utilizar los resultados como referencia para detectar cambios en producción.
El contraste tiene valor cuando se hace bajo carga sostenida y durante picos de demanda, no solo en una prueba breve. También conviene dejar claro dónde empieza y termina cada medición: si una herramienta calcula el tiempo entre tokens de forma distinta a otra, comparar sus resultados puede inducir a error. NVIDIA advierte que las implementaciones varían y que las definiciones deben coincidir antes de comparar cifras.
El rendimiento agregado tampoco equivale a la experiencia individual. NVIDIA distingue entre los tokens por segundo del sistema y los de cada usuario: al aumentar la concurrencia, puede crecer el caudal total mientras empeora el ritmo percibido por cada persona. El sistema puede producir más en conjunto y, a la vez, ofrecer una respuesta más lenta a cada petición.
Una metodología de NVIDIA para NIM con Run:ai y Kubernetes sin ese scheduler ilustra cómo construir pruebas comparables: evalúa cargas con Meta Llama 3.1 8B Instruct y DeepSeek R1 Distill Llama 8B, usa prompts y salidas de 2.000 y 200 tokens en el caso de resumen, y escala pods y GPU bajo distintas configuraciones. El documento también establece un umbral de latencia cercano a 1.000 ms para evaluar la capacidad de usuarios concurrentes. Es una metodología para esos modelos y condiciones, no una garantía aplicable a cualquier servicio.
Escalar no siempre elimina el cuello de botella
Una ocupación elevada de GPU no identifica qué está demorando las peticiones. HPE plantea comprobar si los pods de inferencia escalan con métricas adecuadas para la carga, si las solicitudes llegan al modelo previsto y si los componentes relacionados pueden programarse cuando hacen falta. Un cambio en la mezcla de modelos también puede alterar latencia y capacidad, aunque la actividad de la GPU parezca normal.
La investigación puede extenderse a la configuración de red, la respuesta de una base de datos o de una base vectorial, y el tamaño de la partición de GPU asignada al modelo. Son posibles puntos de inspección, no explicaciones universales. La forma de distinguirlos es correlacionar las solicitudes afectadas y su ventana temporal con las señales del servicio y de la infraestructura.
Kubernetes permite que el Horizontal Pod Autoscaler (HPA) ajuste el número de pods de un Deployment o StatefulSet usando métricas observadas. Además de métricas de CPU y memoria, puede utilizar métricas personalizadas o externas. Así, no es obligatorio sustituir el HPA porque el uso de CPU no represente bien una carga de inferencia; sí hace falta alimentar y probar la métrica que refleje esa carga.
El HPA funciona mediante un ciclo de control periódico, no como una reacción continua. Kubernetes documenta un intervalo predeterminado de 15 segundos entre consultas de métricas. Incluso si la señal indica que hacen falta más réplicas, el escalado no crea GPU disponible de inmediato. Los límites configurados, la capacidad del acelerador y el tiempo para poner pods listos condicionan lo que la política puede lograr.
También hay una tensión entre reaccionar deprisa y evitar oscilaciones. Kubernetes conserva durante una ventana las recomendaciones de escalado y, por defecto, estabiliza las reducciones durante cinco minutos para suavizar bajadas bruscas de réplicas. Para equipos que ajustan capacidad a una carga variable, eso puede reducir el vaivén, aunque significa que el recorte de capacidad no sigue cada descenso de demanda al instante.
La asignación fraccionada de GPU es otra decisión que debe comprobarse con la carga concreta. La metodología de NVIDIA compara despliegues con GPU completas y fraccionadas para sus modelos y escenarios de prueba. El documento describe además el uso de Run:ai para ajustar réplicas según throughput, latencia o usuarios concurrentes. Estos resultados no permiten concluir que una fracción concreta sea suficiente para otro modelo: el perfil y los requisitos de memoria afectan a la capacidad por réplica.
Observabilidad, calidad y coste en la misma decisión
HPE presenta Morpheus como plataforma de aprovisionamiento y automatización, y OpsRamp como herramienta de observabilidad y monitorización de infraestructura y aplicaciones. Según Ramachandran, el objetivo de combinar ambas es relacionar actividad del modelo y de los agentes —como volúmenes y tasas de tokens, latencia de inferencia y TTFT— con la telemetría de soporte. La utilidad está en acotar si una respuesta lenta apunta a la aplicación, al servicio de modelos o a la infraestructura; cada despliegue debe comprobar qué componente emite cada señal y qué instrumentación adicional necesita.
La observabilidad técnica tampoco determina si la respuesta es buena. Bogoevici plantea evaluar si el servicio responde correctamente o alucina. La telemetría puede confirmar que se atendió una solicitud, pero la calidad requiere pruebas representativas y criterios de aceptación definidos por los equipos de datos y especialistas del dominio. Esa evaluación debe repetirse después de cambios en el modelo, el prompt, la recuperación de información o el sistema de serving.
Medir más también implica decidir qué datos quedan registrados. Bogoevici advierte que los prompts, las respuestas y los documentos recuperados pueden aparecer en logs y trazas. Por tanto, hay que definir qué se recopila, dónde se almacena, durante cuánto tiempo y quién puede consultarlo. En particular, el material sensible no deja de serlo por haberse capturado para diagnosticar un problema.
La decisión de lanzamiento reúne cuestiones que suelen estar repartidas entre varios equipos: rendimiento, calidad, capacidad, coste, seguridad y respuesta ante fallos. Ramachandran pide acordar el valor empresarial esperado, incluido un volumen de inferencia plausible ligado a un resultado de negocio. Subramanian sostiene que la aprobación no puede recaer en una sola persona: deben participar administración de plataforma, aprendizaje automático, ciencia de datos y seguridad, además del responsable de negocio pertinente.
La consecuencia operativa es concreta: una GPU ocupada no basta como criterio de éxito ni como disparador único para escalar. La línea base debe vincular la espera del usuario y la calidad de la respuesta con la capacidad y el estado de la infraestructura. Después del lanzamiento, comparar esas medidas con las pruebas previas permite detectar regresiones y decidir si hace falta ajustar el modelo, la ruta de las peticiones o los recursos disponibles.
Fuentes: The New Stack, NVIDIA, NVIDIA, Kubernetes