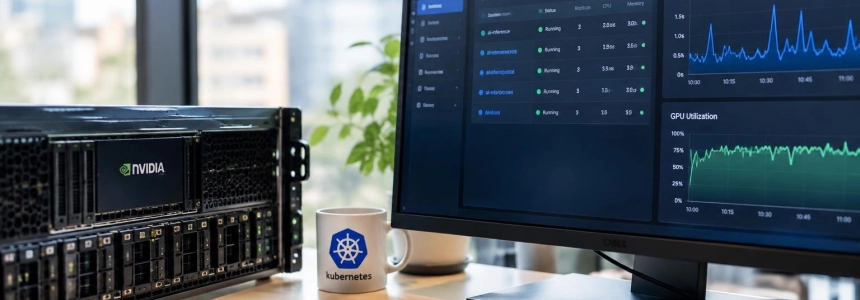
Una GPU al 100% può essere un segnale di saturazione, non di successo. In un’applicazione IA su Kubernetes, il cluster può apparire sano mentre gli utenti aspettano troppo per ricevere una risposta, oppure ricevono una risposta rapida ma sbagliata. La sfida consiste nel collegare ciò che sperimenta l’utente al modello, ai pod e alle risorse di calcolo, archiviazione e rete.
È questo il problema sollevato da The New Stack in un articolo su inferenza e osservabilità, con i contributi di Marius Bogoevici, Mahesh Ramachandran e Karthik Subramanian di HPE. La loro tesi centrale è pratica: l’attività dell’acceleratore, da sola, non dice se il servizio soddisfa le esigenze dell’azienda. Occorre misurarlo prima della produzione e poi confrontare il comportamento reale con quel riferimento.
“A quick first token can mask slow subsequent generation; a fast complete response can still be inaccurate or unhelpful.”
— Marius Bogoevici, Senior Principal Product Manager for HPE Morpheus Software
La prima risposta non racconta tutta la storia
In un servizio conversazionale, il tempo al primo token (TTFT) misura quanto tempo occorre perché compaia l’inizio della risposta. Il tempo necessario per completare la richiesta, invece, include la generazione del resto. Tra i due, la latenza tra token — chiamata anche tempo per token di output — aiuta a osservare il ritmo di generazione una volta che il modello ha iniziato a rispondere.
NVIDIA definisce il TTFT come il tempo che intercorre tra l’invio della richiesta e la ricezione del primo token. Questo intervallo può includere l’attesa in coda, l’elaborazione iniziale del prompt e la latenza di rete. La latenza end-to-end misura il tempo necessario per ricevere la risposta completa e include, tra gli altri componenti, la coda, il batching e la rete. Sono misure diverse, non varianti intercambiabili dello stesso valore.
Anche la lunghezza dell’input è importante. NVIDIA segnala che un prompt più lungo può aumentare il TTFT perché il modello deve elaborare la sequenza di input prima di iniziare a generare. Una misurazione che osserva solo il primo token può non rilevare una generazione successiva lenta; una che calcola solo il tempo totale può nascondere se l’utente ha dovuto aspettare troppo prima di vedere un qualsiasi risultato.
Per questo Bogoevici consiglia di combinare le misure di latenza con affidabilità, capacità, efficienza delle risorse, costi e qualità delle risposte. Non tutte le applicazioni richiedono gli stessi obiettivi: la combinazione appropriata dipende dall’esperienza che il team intende offrire. Il criterio non dovrebbe essere un singolo numero, ma la capacità del servizio di rispettare gli obiettivi fissati per il suo specifico utilizzo.
Una baseline prima del traffico reale
Mahesh Ramachandran propone di profilare il sistema di inferenza prima che i clienti ne dipendano. I test dovrebbero riprodurre lunghezze rappresentative di prompt e contesto, volumi di output e livelli di traffico. In queste condizioni, i team possono registrare latenza, token elaborati e metriche del servizio, e usare i risultati come riferimento per rilevare cambiamenti in produzione.
Il confronto è utile se viene effettuato sotto carico sostenuto e durante i picchi di domanda, non solo con un test breve. È inoltre opportuno chiarire dove inizia e dove termina ogni misurazione: se uno strumento calcola il tempo tra token in modo diverso da un altro, confrontare i risultati può essere fuorviante. NVIDIA avverte che le implementazioni variano e che le definizioni devono coincidere prima di confrontare i valori.
Le prestazioni aggregate non equivalgono neppure all’esperienza individuale. NVIDIA distingue tra i token al secondo del sistema e quelli di ogni utente: all’aumentare della concorrenza, il throughput totale può crescere mentre peggiora il ritmo percepito da ciascuna persona. Nel complesso, il sistema può produrre di più e, allo stesso tempo, offrire una risposta più lenta a ogni richiesta.
Una metodologia NVIDIA per NIM con Run:ai e Kubernetes senza quello scheduler illustra come realizzare test comparabili: valuta carichi con Meta Llama 3.1 8B Instruct e DeepSeek R1 Distill Llama 8B, usa prompt e output di 2.000 e 200 token nel caso della sintesi e aumenta il numero di pod e GPU con diverse configurazioni. Il documento stabilisce inoltre una soglia di latenza vicina a 1.000 ms per valutare la capacità di utenti concorrenti. È una metodologia valida per quei modelli e quelle condizioni, non una garanzia applicabile a qualsiasi servizio.
Scalare non elimina sempre il collo di bottiglia
Un’elevata occupazione della GPU non permette di identificare cosa sta rallentando le richieste. HPE suggerisce di verificare se i pod di inferenza scalano usando metriche adeguate al carico, se le richieste raggiungono il modello previsto e se i componenti correlati possono essere pianificati quando servono. Anche una variazione nella combinazione di modelli può modificare latenza e capacità, sebbene l’attività della GPU sembri normale.
L’indagine può estendersi alla configurazione di rete, alla risposta di un database o di un database vettoriale e alle dimensioni della partizione GPU assegnata al modello. Sono possibili punti di verifica, non spiegazioni universali. Per distinguerli, occorre correlare le richieste interessate e la relativa finestra temporale con i segnali del servizio e dell’infrastruttura.
Kubernetes consente all’Horizontal Pod Autoscaler (HPA) di regolare il numero di pod di un Deployment o StatefulSet usando le metriche osservate. Oltre alle metriche di CPU e memoria, può utilizzare metriche personalizzate o esterne. Non è quindi obbligatorio sostituire l’HPA perché l’utilizzo della CPU non rappresenta bene un carico di inferenza; occorre però fornire e testare la metrica che riflette quel carico.
L’HPA funziona tramite un ciclo di controllo periodico, non come una reazione continua. Kubernetes documenta un intervallo predefinito di 15 secondi tra le interrogazioni delle metriche. Anche se il segnale indica che servono più repliche, lo scaling non rende immediatamente disponibile una GPU. I limiti configurati, la capacità dell’acceleratore e il tempo necessario per rendere pronti i pod condizionano ciò che la policy può ottenere.
Esiste inoltre una tensione tra reagire rapidamente ed evitare oscillazioni. Kubernetes conserva le raccomandazioni di scaling per una finestra temporale e, per impostazione predefinita, stabilizza le riduzioni per cinque minuti per attenuare i cali bruschi del numero di repliche. Per i team che adeguano la capacità a un carico variabile, ciò può ridurre le oscillazioni, ma significa che la capacità non viene ridotta immediatamente a ogni calo della domanda.
L’allocazione frazionata della GPU è un’altra decisione da verificare con il carico specifico. La metodologia NVIDIA confronta distribuzioni con GPU intere e frazionate per i propri modelli e scenari di test. Il documento descrive inoltre l’uso di Run:ai per regolare le repliche in base a throughput, latenza o utenti concorrenti. Questi risultati non consentono di concludere che una determinata frazione sia sufficiente per un altro modello: il profilo e i requisiti di memoria influiscono sulla capacità per replica.
Osservabilità, qualità e costi nella stessa decisione
HPE presenta Morpheus come piattaforma di provisioning e automazione e OpsRamp come strumento di osservabilità e monitoraggio di infrastruttura e applicazioni. Secondo Ramachandran, l’obiettivo di combinarli è mettere in relazione l’attività del modello e degli agenti — come i volumi e i tassi di token, la latenza di inferenza e il TTFT — con la telemetria di supporto. L’utilità consiste nel circoscrivere se una risposta lenta dipende dall’applicazione, dal servizio di modelli o dall’infrastruttura; ogni distribuzione deve verificare quale componente emette ciascun segnale e quale strumentazione aggiuntiva è necessaria.
L’osservabilità tecnica non determina neppure se la risposta è buona. Bogoevici propone di valutare se il servizio risponde correttamente o ha allucinazioni. La telemetria può confermare che una richiesta è stata gestita, ma la qualità richiede test rappresentativi e criteri di accettazione definiti dai team di dati e dagli specialisti del dominio. Questa valutazione va ripetuta dopo modifiche al modello, al prompt, al recupero delle informazioni o al sistema di serving.
Misurare di più significa anche decidere quali dati vengono registrati. Bogoevici avverte che i prompt, le risposte e i documenti recuperati possono comparire nei log e nelle tracce. Occorre quindi definire cosa viene raccolto, dove viene archiviato, per quanto tempo e chi può consultarlo. In particolare, i dati sensibili non smettono di esserlo perché sono stati acquisiti per diagnosticare un problema.
La decisione di lancio riunisce questioni spesso distribuite tra più team: prestazioni, qualità, capacità, costi, sicurezza e risposta ai guasti. Ramachandran chiede di concordare il valore aziendale atteso, incluso un volume di inferenza plausibile legato a un risultato di business. Subramanian sostiene che l’approvazione non può spettare a una sola persona: devono partecipare i responsabili della piattaforma, del machine learning, della data science e della sicurezza, oltre al responsabile aziendale pertinente.
La conseguenza operativa è concreta: una GPU occupata non basta come criterio di successo né come unico fattore che attiva lo scaling. La baseline deve collegare l’attesa dell’utente e la qualità della risposta alla capacità e allo stato dell’infrastruttura. Dopo il lancio, confrontare queste misure con i test precedenti permette di rilevare regressioni e decidere se occorre modificare il modello, il percorso delle richieste o le risorse disponibili.
Fonti: The New Stack, NVIDIA, NVIDIA, Kubernetes