Los modelos evaluados por METR duplican aproximadamente cada 3,6 meses el tiempo de tarea que pueden abordar con una probabilidad de éxito del 50 %, según la actualización publicada el 20 de noviembre. Pero el dato no resuelve la pregunta que preocupa a la organización: si la IA puede acelerar la investigación hasta el punto de que las personas no logren evaluar y responder a tiempo a sus riesgos.
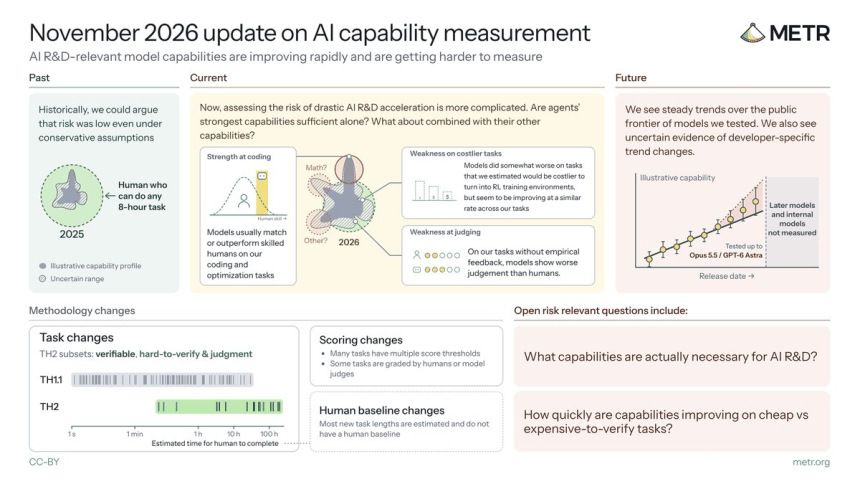
METR, organización de investigación en IA, evaluó modelos públicos hasta Opus 5.5 y GPT-6 Astra. Su conclusión combina dos señales distintas: avances fuertes en tareas de programación y optimización con métricas claras, y incertidumbre sobre la aceleración de la investigación en IA. La organización afirma que los datos públicos disponibles no bastan para descartar una aceleración drástica en los próximos años.
Por aceleración drástica, METR entiende una situación en la que las capacidades progresan tan deprisa que las personas dejan de poder «meaningfully understand, assess, and react to catastrophic risks posed by new AI systems». La cita expresa el umbral de riesgo que estudia; no es una predicción de que ese escenario ya esté ocurriendo.
“to meaningfully understand, assess, and react to catastrophic risks posed by new AI systems”
— METR
El avance es más claro cuando hay una métrica
En tareas de programación y optimización con objetivos definidos y resultados comprobables, los modelos suelen igualar o superar a personas cualificadas. METR también encontró casos en los que sus modelos quedaron en percentiles altos frente a grupos de más de diez especialistas, aunque no necesariamente por encima de los mejores. La frontera observada es, por tanto, más precisa que decir que la IA ya supera a los expertos en general.
La diferencia importa: en un problema verificable, el agente puede comparar su resultado con una puntuación, una prueba o un objetivo de optimización. En tareas abiertas, donde no hay una señal rápida de progreso, la organización detectó peor juicio que el de expertos humanos. En una de ellas, los evaluadores basados en modelos sobrestimaron la calidad de una respuesta cuando la había producido otro modelo de capacidad similar o superior.
METR separa sus evaluaciones en tres conjuntos. Time Horizon 1.1 reúne tareas de ingeniería de software; MirrorCode se centra en replicar software desde la línea de comandos; y TH2 añade tanto objetivos verificables como investigación y evaluación difíciles de puntuar. Esa mezcla amplía el foco, pero también hace que una cifra agregada dependa de qué tareas se incluyan.
| Conjunto | Tareas | Enfoque |
|---|---|---|
| Time Horizon 1.1 | 222 | Tareas que incluyen SWAA, HCAST y RE-Bench. |
| MirrorCode | 75 | Replicación de software mediante herramientas de línea de comandos. |
| TH2 | 36, agrupadas en 12 familias | Optimización, aprendizaje automático, juegos, investigación abierta y juicio. |
En el conjunto combinado de Time Horizon 1.1 y TH2, METR estima que el horizonte temporal se duplica cada 3,6 meses, aproximadamente. TH2 contiene tareas más difíciles, por lo que la probabilidad de éxito del 50 % de un mismo modelo corresponde a un horizonte menor en la combinación que en Time Horizon 1.1 por separado. No es una medida directa de productividad en empresas ni un calendario universal para las capacidades de IA.
Una tendencia rápida, pero no una aceleración demostrada
La cifra de 3,6 meses mide cuánto se alargan las tareas que los modelos pueden completar en las pruebas de METR. En otra medición, el METR Capability Index, que agrupa capacidades de modelos públicos a lo largo del tiempo, la organización no observa una aceleración o desaceleración general marcada entre los modelos probados.
METR sí ve indicios inciertos de cambios en las tendencias de algunos desarrolladores y bajo ciertas condiciones, pero advierte que dependen de decisiones metodológicas. También encuentra que, al excluir Time Horizon 1.1, los tiempos de duplicación son menores en una parte verificable de TH2. Eso podría encajar con una aceleración reciente que la combinación de conjuntos no deja ver, aunque METR señala que hay otras explicaciones posibles.
La lectura prudente no es que todos los modelos vayan a duplicar su utilidad cada trimestre. La estimación se deriva de un conjunto específico de tareas y de cómo se mide el éxito en ellas. METR mantiene abiertas dos preguntas centrales: qué capacidades serían necesarias para acelerar drásticamente la investigación en IA y a qué ritmo están mejorando esas capacidades.
La evaluación también se queda atrás
El problema no es solo que las capacidades cambien deprisa. METR advierte que las pruebas baratas, automatizadas y fáciles de repetir pueden sobrestimar el rendimiento real si se parecen mucho a los entornos utilizados para entrenar los modelos. Cuando un sistema aprende a optimizar una señal cercana a la evaluación, una puntuación alta puede decir menos sobre su rendimiento en situaciones distintas.
La organización llama «Lifecycle Cost» a una estimación del coste de crear, ejecutar y puntuar una tarea de evaluación. En sus datos, los modelos rinden algo peor en tareas más costosas de convertir en entornos de entrenamiento por refuerzo, incluso al tener en cuenta el tiempo estimado que tardaría una persona. Aun así, METR observa ritmos de mejora parecidos en tareas de coste alto y bajo, y progreso también en las más costosas.
El resultado describe un intercambio incómodo para quienes evalúan modelos: las pruebas sencillas ofrecen señales cuantitativas y asequibles, pero pueden ser menos representativas; las tareas más realistas tienden a exigir más trabajo para prepararlas y juzgarlas. METR intentó responder a ese problema con tareas puntuadas manualmente y pruebas que espera que se parezcan menos a los entornos de entrenamiento, aunque la organización reconoce que medir capacidades generalizables sigue siendo difícil.
Qué cambia para equipos que despliegan agentes
Para los equipos de desarrollo, los resultados respaldan una separación práctica entre tareas con criterios de aceptación claros y tareas en las que la calidad depende de contexto o juicio. Los agentes parecen más fiables en el primer grupo: código con pruebas, objetivos numéricos o resultados que pueden comprobarse rápidamente. En el segundo, la ausencia de una señal clara debilita tanto la evaluación automática como la confianza en que el propio modelo valore bien su trabajo.
Esto afecta también a cómo una empresa compara modelos o decide dónde usarlos. Una puntuación en una evaluación económica y repetible puede ser útil, pero no demuestra por sí sola que el sistema vaya a rendir igual en el flujo de trabajo real. La advertencia de METR es especialmente relevante cuando la prueba y el entrenamiento comparten características: el resultado puede reflejar familiaridad con ese tipo de entorno, no necesariamente capacidad transferible.
La actualización estudia además los enjambres de agentes, es decir, varios agentes trabajando en paralelo. METR los encontró útiles frente a una estrategia de escoger el mejor resultado entre varias ejecuciones en tareas verificables con métricas claras y retroalimentación rápida. En los demás tipos de tarea, sus efectos fueron inciertos o negativos. La paralelización, por tanto, no aparece como una mejora general independiente del problema.
La organización también cambió cómo construye sus referencias humanas. Reclutó evaluadores con más experiencia, pero le resultó difícil conseguir suficientes participantes para tareas especializadas. Las mediciones humanas directas aportan solo el 9 % de las estimaciones sobre cuánto tardaría una persona; para el resto, METR recurre a procedimientos basados en registros públicos, aportaciones de expertos y extrapolaciones. Esa limitación añade incertidumbre al comparar la duración de las tareas con el rendimiento humano.
La conclusión operativa es acotada: la mejora en tareas con señales claras es rápida, pero no equivale a una autonomía fiable en trabajos donde el éxito tarda en aparecer o no puede comprobarse fácilmente. La incógnita que queda es si los modelos mejorarán también en ese tipo de juicio o si los avances seguirán concentrándose en objetivos fáciles de medir.
Fuentes: The Decoder, METR, New Runtime