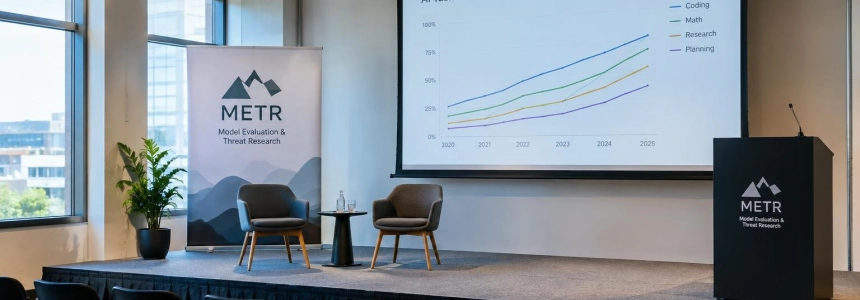
I modelli valutati da METR raddoppiano all’incirca ogni 3,6 mesi il tempo delle attività che possono affrontare con una probabilità di successo del 50%, secondo l’aggiornamento pubblicato il 20 novembre. Ma questo dato non risolve la domanda che preoccupa l’organizzazione: se l’IA possa accelerare la ricerca al punto che le persone non riescano a valutare i rischi e a rispondervi in tempo.
METR, organizzazione di ricerca sull’IA, ha valutato modelli pubblici fino a Opus 5.5 e GPT-6 Astra. La sua conclusione combina due segnali distinti: notevoli progressi nelle attività di programmazione e ottimizzazione con metriche chiare e incertezza sull’accelerazione della ricerca sull’IA. L’organizzazione afferma che i dati pubblici disponibili non bastano a escludere una drastica accelerazione nei prossimi anni.
Per drastica accelerazione, METR intende una situazione in cui le capacità progrediscono così rapidamente che le persone non riescono più a «comprendere, valutare e reagire in modo significativo ai rischi catastrofici posti dai nuovi sistemi di IA». La citazione esprime la soglia di rischio che l’organizzazione studia; non è una previsione che questo scenario si stia già verificando.
“to meaningfully understand, assess, and react to catastrophic risks posed by new AI systems”
— METR
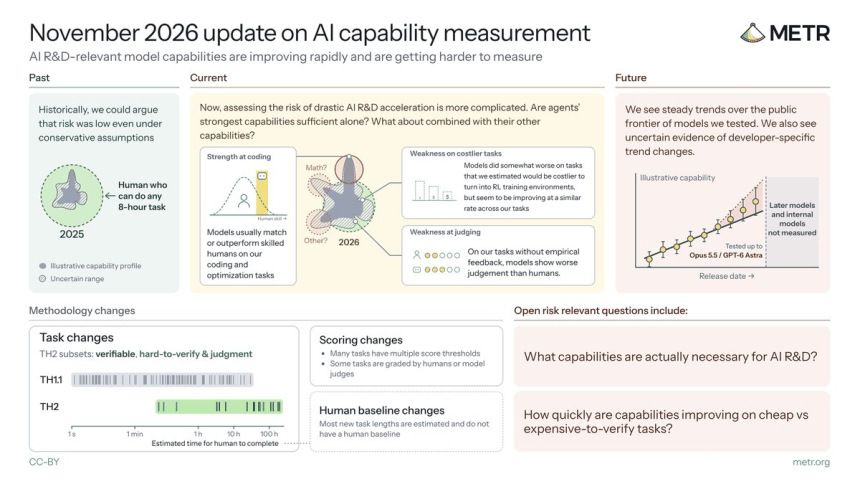
I progressi sono più evidenti quando c’è una metrica
Nelle attività di programmazione e ottimizzazione con obiettivi definiti e risultati verificabili, i modelli spesso eguagliano o superano persone qualificate. METR ha anche riscontrato casi in cui i suoi modelli si sono collocati a percentili elevati rispetto a gruppi di oltre dieci specialisti, senza necessariamente superare i migliori. La frontiera osservata è quindi più precisa dell’affermazione secondo cui l’IA avrebbe già superato gli esperti in generale.
La differenza è importante: in un problema verificabile, l’agente può confrontare il proprio risultato con un punteggio, un test o un obiettivo di ottimizzazione. Nelle attività aperte, dove non esiste un segnale rapido di progresso, l’organizzazione ha rilevato un giudizio peggiore rispetto a quello degli esperti umani. In uno dei casi, i valutatori basati su modelli hanno sovrastimato la qualità di una risposta quando era stata prodotta da un altro modello con capacità simili o superiori.
METR suddivide le proprie valutazioni in tre insiemi. Time Horizon 1.1 raccoglie attività di ingegneria del software; MirrorCode si concentra sulla replica di software dalla riga di comando; e TH2 comprende sia obiettivi verificabili sia attività di ricerca e valutazione difficili da quantificare. Questa varietà amplia il campo d’indagine, ma fa anche sì che una cifra aggregata dipenda dalle attività incluse.
| Insieme | Attività | Ambito |
|---|---|---|
| Time Horizon 1.1 | 222 | Attività che includono SWAA, HCAST e RE-Bench. |
| MirrorCode | 75 | Replica di software tramite strumenti da riga di comando. |
| TH2 | 36, raggruppate in 12 famiglie | Ottimizzazione, apprendimento automatico, giochi, ricerca aperta e giudizio. |
Nell’insieme combinato di Time Horizon 1.1 e TH2, METR stima che l’orizzonte temporale raddoppi ogni circa 3,6 mesi. TH2 include attività più difficili, quindi la probabilità di successo del 50% per uno stesso modello corrisponde a un orizzonte più breve nell’insieme combinato rispetto a Time Horizon 1.1 preso singolarmente. Non è una misura diretta della produttività nelle aziende né una tempistica universale per le capacità dell’IA.
Una tendenza rapida, ma non un’accelerazione dimostrata
La cifra di 3,6 mesi misura quanto si allungano le attività che i modelli riescono a completare nei test di METR. In un’altra misurazione, il METR Capability Index, che riunisce le capacità dei modelli pubblici nel tempo, l’organizzazione non osserva un’accelerazione o un rallentamento generale marcato tra i modelli testati.
METR rileva alcuni indizi incerti di cambiamenti nelle tendenze di determinati sviluppatori e in certe condizioni, ma avverte che dipendono da scelte metodologiche. Inoltre, escludendo Time Horizon 1.1, i tempi di raddoppio risultano inferiori in una parte verificabile di TH2. Questo potrebbe essere compatibile con una recente accelerazione che la combinazione degli insiemi non rende visibile, anche se METR sottolinea che sono possibili altre spiegazioni.
L’interpretazione prudente non è che tutti i modelli raddoppieranno la propria utilità ogni trimestre. La stima deriva da un insieme specifico di attività e dal modo in cui vi si misura il successo. METR lascia aperte due questioni centrali: quali capacità sarebbero necessarie per accelerare drasticamente la ricerca sull’IA e a quale ritmo queste capacità stiano migliorando.
Anche la valutazione resta indietro
Il problema non è soltanto che le capacità cambiano rapidamente. METR avverte che i test economici, automatizzati e facili da ripetere possono sovrastimare le prestazioni reali se somigliano molto agli ambienti usati per addestrare i modelli. Quando un sistema impara a ottimizzare un segnale simile a quello della valutazione, un punteggio elevato può dire meno sulle sue prestazioni in situazioni diverse.
L’organizzazione chiama «Lifecycle Cost» una stima del costo di creazione, esecuzione e valutazione di un test. Nei suoi dati, i modelli ottengono risultati leggermente peggiori nelle attività più costose da trasformare in ambienti di addestramento per rinforzo, anche tenendo conto del tempo stimato che impiegherebbe una persona. Ciononostante, METR osserva ritmi di miglioramento simili nelle attività a costo alto e basso, e progressi anche in quelle più costose.
Il risultato descrive un compromesso scomodo per chi valuta i modelli: i test semplici forniscono segnali quantitativi e accessibili, ma possono essere meno rappresentativi; le attività più realistiche tendono a richiedere più lavoro per essere preparate e valutate. METR ha cercato di affrontare il problema con attività valutate manualmente e test che, secondo le sue aspettative, somigliano meno agli ambienti di addestramento, pur riconoscendo che misurare capacità generalizzabili resta difficile.
Cosa cambia per i team che implementano agenti
Per i team di sviluppo, i risultati avvalorano una distinzione pratica tra attività con criteri di accettazione chiari e attività in cui la qualità dipende dal contesto o dal giudizio. Gli agenti sembrano più affidabili nel primo gruppo: codice con test, obiettivi numerici o risultati verificabili rapidamente. Nel secondo, l’assenza di un segnale chiaro indebolisce sia la valutazione automatica sia la fiducia nella capacità del modello di giudicare correttamente il proprio lavoro.
Questo incide anche sul modo in cui un’azienda confronta i modelli o decide dove impiegarli. Un punteggio ottenuto in una valutazione economica e ripetibile può essere utile, ma da solo non dimostra che il sistema avrà prestazioni analoghe nel flusso di lavoro reale. L’avvertimento di METR è particolarmente rilevante quando test e addestramento condividono alcune caratteristiche: il risultato può riflettere la familiarità con quel tipo di ambiente, non necessariamente una capacità trasferibile.
L’aggiornamento esamina anche gli sciami di agenti, cioè più agenti che lavorano in parallelo. METR li ha ritenuti utili rispetto a una strategia che sceglie il risultato migliore tra diverse esecuzioni, nelle attività verificabili con metriche chiare e feedback rapidi. Negli altri tipi di attività, gli effetti sono risultati incerti o negativi. La parallelizzazione, quindi, non emerge come un miglioramento generale indipendente dal problema.
L’organizzazione ha anche modificato il modo in cui costruisce i propri riferimenti umani. Ha reclutato valutatori con maggiore esperienza, ma ha avuto difficoltà a trovare un numero sufficiente di partecipanti per le attività specialistiche. Le misurazioni umane dirette rappresentano solo il 9% delle stime sul tempo che impiegherebbe una persona; per il resto, METR ricorre a procedure basate su registri pubblici, contributi di esperti ed estrapolazioni. Questo limite aggiunge incertezza nel confrontare la durata delle attività con le prestazioni umane.
La conclusione operativa è circoscritta: i progressi nelle attività con segnali chiari sono rapidi, ma non equivalgono a un’autonomia affidabile nei lavori in cui il successo emerge lentamente o non può essere verificato facilmente. Resta da capire se i modelli miglioreranno anche in questo tipo di giudizio o se i progressi continueranno a concentrarsi su obiettivi facili da misurare.
Fonti: The Decoder, METR, New Runtime