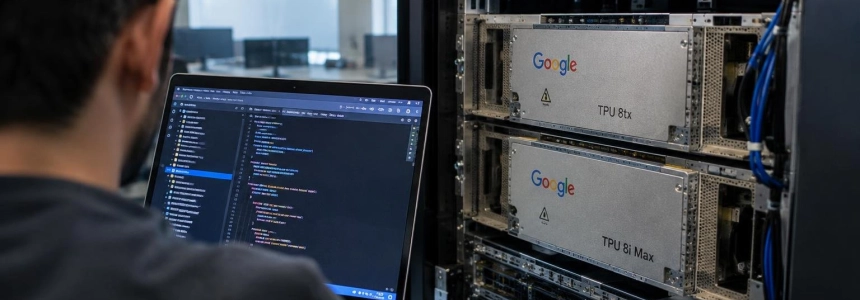
Google presentó dos nuevas configuraciones de sus aceleradores TPU: la 8tx, centrada en la inferencia confidencial, y la 8i Max, pensada para cargas que necesitan más memoria y capacidad de cálculo. No son una nueva generación de silicio: ambas parten de procesadores existentes y amplían la octava generación, que ahora reúne cuatro sistemas en un año por primera vez.
La maniobra apunta a un objetivo más amplio que añadir modelos al catálogo. Google intenta convertir sus chips, concebidos inicialmente para sus propios servicios, en una plataforma que puedan contratar y usar empresas externas. La competencia con Nvidia pasa así por dos frentes: ofrecer configuraciones adecuadas para cargas concretas y reducir las barreras de software que pueden mantener a los equipos en el ecosistema de GPU.
Cuatro sistemas para distintas fases de la IA
La familia queda repartida entre cuatro usos, según Google: la TPU 8t para entrenamiento a gran escala; la 8i para razonamiento de baja latencia; la 8tx para procesamiento confidencial; y la 8i Max para ventanas de contexto amplias y mayor densidad de cálculo por rack. La compañía describe las dos últimas como nuevas configuraciones de la generación presentada anteriormente, no como nuevos chips diseñados desde cero.
flowchart TD
A["TPU 8t: entrenamiento"]
B["TPU 8i: razonamiento"]
C["TPU 8tx: inferencia confidencial"]
D["TPU 8i Max: contexto amplio"]
Ese matiz importa para entender la estrategia técnica. Google separa la evolución del procesador de la configuración del sistema que lo rodea: empaquetado, memoria, red y seguridad. Amin Vahdat, vicepresidente sénior y responsable tecnológico de IA e infraestructura de Google, explica que la compañía diseñó sus TPU como bloques modulares para ajustar esos componentes con más rapidez que la que exige fabricar una nueva generación de silicio.
“With computing moving from human to agent scale, businesses are asking for accelerators that can reason across AI models’ massive context windows.”
— Amin Vahdat, SVP and Chief Technologist, AI and Infrastructure
Google sostiene que este enfoque permite ofrecer sistemas especializados en meses, en lugar de esperar años a un nuevo chip. La 8t y la 8i ya cubrían entrenamiento y razonamiento; las nuevas variantes responden, según la empresa, a solicitudes de clientes sobre datos sensibles y contextos de mayor tamaño.
La 8tx protege datos mientras se procesan
La TPU 8tx apunta a organismos públicos y compañías de sectores regulados que quieren ejecutar modelos y agentes sobre información sensible. El problema que aborda es concreto: los datos suelen estar cifrados mientras se almacenan o viajan por una red, pero el procesamiento requiere que el equipo pueda utilizarlos. Google afirma que en la 8tx los datos y los pesos del modelo permanecen protegidos y aislados también durante el uso activo.
La configuración parte del mismo silicio que la TPU 8t y, según Google, se combina con procesadores anfitriones AMD EPYC de quinta generación. También incorpora seguridad a nivel de hardware y la red Boardfly de baja latencia, que la compañía había desarrollado para razonamiento en tiempo real. Google atribuye a la 8tx hasta el doble de reducción de latencia frente a la 8t, con una penalización de rendimiento «casi nula».
La combinación está pensada para ejecutar varias tareas sin trasladar datos privados entre clústeres distintos. Google enumera el ajuste fino de modelos con datos propios, la destilación de modelos grandes en otros más pequeños y el entrenamiento de agentes mediante aprendizaje por refuerzo. Reuters también describe la 8tx como una alternativa para empresas reguladas y organismos públicos que necesitan mantener protegida la información durante el procesamiento.
La función no parte de un terreno sin competencia: The Decoder señala que Nvidia ya ofrece una capacidad comparable para sus GPU mediante su arquitectura de computación confidencial. Por eso, la propuesta de Google no consiste solo en añadir cifrado, sino en empaquetar esa protección con su acelerador, la red de baja latencia y tareas de entrenamiento e inferencia en un mismo sistema.
La 8i Max intenta aliviar el límite de memoria
La TPU 8i Max aborda otra restricción. Cuando varios agentes trabajan sobre repositorios de código amplios o grandes volúmenes de vídeo, el acceso a memoria puede frenar el procesamiento. Google combina dos chips TPU 8i en un solo paquete para aumentar los recursos disponibles sin cambiar el formato del rack.
La compañía afirma que la 8i Max duplica la capacidad de cálculo, la memoria SRAM y el ancho de banda de memoria HBM de la 8i. También sostiene que cabe el doble de silicio en la misma huella de rack, lo que eleva la capacidad de cálculo por superficie. La propuesta se dirige a aplicaciones que necesitan consultar mucha información en una misma interacción, como asistentes de programación, razonamiento matemático y descubrimiento de fármacos, según Reuters.
El intercambio es claro: en lugar de presentar una arquitectura completamente nueva, Google concentra más recursos en el mismo formato físico. Su utilidad dependerá de que las cargas de trabajo aprovechen ese aumento de memoria y ancho de banda; la empresa presenta la configuración como una respuesta a contextos grandes y a trabajos que se atascan cuando los datos no llegan al procesador con suficiente rapidez.
El software decidirá cuánto cuesta cambiar
Para los equipos de desarrollo, el hardware por sí solo no resuelve el coste de adoptar una plataforma distinta. Google está acompañando las TPU con herramientas para acercarlas a flujos de trabajo existentes. La empresa abrió TorchTPU como código abierto y afirma que permite ejecutar código de PyTorch y modelos de Hugging Face en sus aceleradores sin reescrituras. También menciona compatibilidad con los motores de inferencia vLLM y SGLang.
Google añade una suite de agentes TPU, todavía en vista previa, que se integra con herramientas de programación como Claude Code, Cursor y Google Antigravity para ayudar a incorporar cargas, diagnosticar cuellos de botella y ajustar kernels. Para producción, presenta XLA Serving Engine como una vía para entrenar modelos en Python y servirlos mediante un entorno C++ de baja latencia en TPU, GPU y CPU. Son piezas orientadas a reducir el trabajo de adaptación; su presencia no demuestra por sí sola que todas las aplicaciones PyTorch vayan a funcionar sin ajustes.
La compañía también pone el foco en problemas específicos de cargas basadas en agentes. Su Agent Compute Engine suspende y reanuda sesiones inactivas mientras esperan una consulta a una base de datos, una herramienta externa o una respuesta humana. TPU Sync, que Google está abriendo como código, organiza la memoria de los aceleradores, la memoria del anfitrión, el almacenamiento compartido y la red como una jerarquía. Google dice que puede trasladar cachés KV fuera del chip y reducir en más del 90% la latencia de transferencia de caché y el tiempo hasta el primer token en sus escenarios descritos.
La empresa también anuncia Cloud Pathways, ya disponible en Google Kubernetes Engine, para orquestar sistemas TPU distribuidos desde un único controlador. GKE dynamic slicing, también disponible de forma general, permite reorganizar topologías de TPU; Google le atribuye una reducción de hasta cinco veces en los tiempos de inicio de trabajos y una recuperación de fallos hasta 4,5 veces más rápida. Son cifras y resultados comunicados por Google, no una comparación independiente con plataformas rivales.
La presión competitiva se desplaza hacia la inferencia
La apuesta externa marca un cambio para una tecnología que Google había usado sobre todo en productos propios como Search, YouTube y Gemini. La compañía afirma que cuenta con casi 100 clientes externos de TPU, entre ellos laboratorios de frontera, firmas de trading, minoristas y universidades. Reuters informa de que las ventas de TPU contribuyeron de forma significativa a los resultados del trimestre de septiembre y sitúa los ingresos de Google Cloud en 30.710 millones de dólares, más del doble.
El contexto comercial favorece una oferta más amplia: a medida que se extiende el uso de modelos, las empresas necesitan ejecutar inferencias de forma cotidiana, además de entrenar modelos. Google busca ocupar esa demanda con sistemas especializados y servicios de nube, mientras Microsoft, Amazon, OpenAI y Anthropic también trabajan en aceleradores propios, según The Decoder y TechCrunch.
Nvidia conserva una posición dominante en el mercado de chips de IA y también está reforzando su oferta de inferencia; The Decoder menciona su acuerdo de adquisición de talento y licencias con Groq. Google, por tanto, no compite únicamente con una pieza de silicio. Su desafío es que las configuraciones especializadas, la seguridad, la disponibilidad y las herramientas de desarrollo formen un conjunto atractivo para clientes que hoy pueden elegir GPU o recurrir a otros proveedores.
La pregunta pendiente es cuánto de esa propuesta se traduce en cargas de producción fuera de Google. La empresa ya comunica clientes, herramientas y resultados de rendimiento, pero las nuevas variantes amplían una plataforma cuyo crecimiento externo dependerá de que las organizaciones puedan migrar sus modelos y mantenerlos en funcionamiento con sus requisitos de memoria, latencia y confidencialidad.
Fuentes: The Decoder, Reuters (via Euronext), Google, TechCrunch