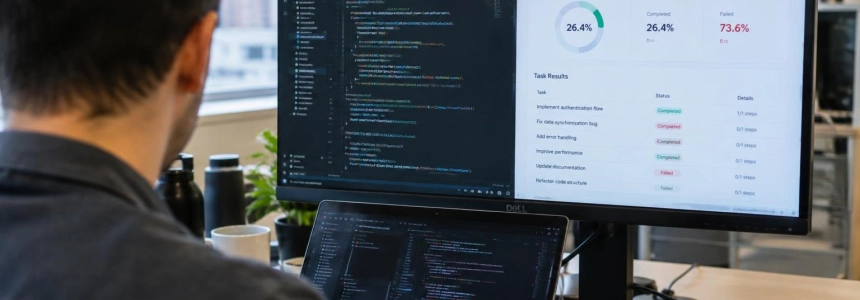
GPT-6 Astra completó solo el 26,4% de las tareas de Co-Design Bench, pese a satisfacer de media el 69,9% de los criterios de aceptación. El resultado, recogido en un benchmark construido con peticiones de sesiones reales de programación, describe una brecha importante: un agente puede resolver buena parte de un encargo y, aun así, no entregar una modificación terminada.
La diferencia entre ambas cifras importa más que una clasificación de modelos. En un proyecto, no basta con que funcionen algunas partes de una petición: si queda sin resolver un requisito, alguien debe detectar qué falta y decidir cómo corregirlo. Los resultados muestran que la satisfacción parcial es mucho más frecuente que la entrega completa.
De instrucciones reales a aplicaciones que deben funcionar
Co-Design Bench fue desarrollado por investigadores de Alibaba y varias universidades asiáticas. El conjunto reúne 273 tareas seleccionadas a partir de 37.463 consultas deduplicadas de 26.314 sesiones de programación, y las evalúa con 2.331 criterios de aceptación ocultos redactados por expertos. En vez de pedir a los modelos que resuelvan ejercicios aislados, les plantea revisar aplicaciones existentes a partir de instrucciones de usuarios.
El conjunto separa dos tipos de trabajo. Multimodal Editing incluye 100 tareas de cambios localizados, a veces apoyados por imágenes, audio, vídeo o documentos. Repository Editing reúne 173 encargos que requieren coordinar modificaciones en distintas partes de un proyecto. Las peticiones pueden abarcar desde extraer una cifra de un recibo y actualizar los totales que dependen de ella hasta reorganizar una aplicación.
Ese planteamiento pone a prueba más que la generación de código. El agente debe entender qué pide la persona, relacionar la instrucción con los archivos o recursos disponibles, cambiar la interfaz y conseguir que la funcionalidad resultante opere de manera coherente. El benchmark agrupa esas exigencias en tres dimensiones: comprensión fundamentada, transformación de la interfaz e implementación funcional.
Las tareas proceden de sesiones reales y los autores favorecieron casos en los que el usuario había tenido que reformular una petición o revertir cambios. No representan, por tanto, una muestra uniforme de cualquier encargo de programación: concentran situaciones que ya habían causado problemas en la práctica. Es una elección deliberada para medir dónde tropiezan los agentes, aunque también limita lo que puede inferirse sobre tareas más sencillas.
El acierto parcial no equivale a una entrega
Los diez modelos evaluados trabajaron bajo un mismo entorno de ejecución. GPT-6 Astra encabezó la comparación con una media de 69,9% de criterios satisfechos, pero solo dejó completamente resueltas algo más de una de cada cuatro tareas. La puntuación por criterio reconoce avances parciales; la tasa de éxito total exige que el agente cumpla todos los requisitos de un encargo.
Para un equipo que utiliza un agente, esa distinción cambia la lectura de los resultados. Una puntuación media alta puede sugerir que el modelo es competente, sin mostrar cuántas entregas están listas para aceptarse tal cual. Si en una misma tarea conviven cambios correctos y uno pendiente, el valor práctico depende de que alguien revise cada requisito y compruebe el comportamiento final.
El protocolo intenta evitar que una implementación aparente pase por una funcional. Un evaluador de IA inspecciona la aplicación en el navegador y puntúa criterios ocultos; después, otro modelo revisa los veredictos positivos y busca, entre otros problemas, resultados codificados de forma rígida o interfaces que solo simulan funcionar. Las evaluaciones combinan pruebas sobre el código y evidencias del navegador, sin exigir una implementación de referencia ni una captura objetivo.
Ese método da más peso a lo que hace la aplicación que a que el código parezca plausible. Sin embargo, sigue dependiendo de evaluadores automatizados, que pueden equivocarse. Además, Co-Design Bench evalúa una petición fija por tarea: no incluye preguntas de seguimiento ni correcciones del usuario durante la ejecución. En una colaboración real, esas aclaraciones podrían cambiar el resultado, pero el benchmark no mide ese intercambio.
Los encargos combinados y el coste de más cómputo
El punto débil más consistente aparece cuando una petición mezcla varias clases de cambio. Los diez modelos obtuvieron peores resultados en modificaciones de repositorio que combinaban tres o cuatro tipos de trabajo que en aquellas limitadas a uno o dos. En los proyectos reales, una revisión puede exigir a la vez ajustes de diseño, contenido, disposición e interacción; el benchmark indica que coordinar esas piezas resulta más difícil que resolverlas por separado.
Eso ayuda a explicar por qué una demostración convincente de una función concreta no basta para anticipar cómo se comportará un agente frente a una petición amplia. Un cambio visual puede quedar bien mientras la interacción asociada falla, o una cifra puede actualizarse en una vista y no en otras. El conjunto incluye encargos de ese tipo, donde la condición de éxito depende de que las partes conectadas se mantengan consistentes.
Dedicar más recursos tampoco resolvió automáticamente el problema. Según The Decoder, GLM-5.2 consumió casi seis veces más tokens que GPT-6 Astra en cambios pequeños y, aun así, obtuvo una puntuación significativamente inferior. El dato no establece que más cómputo nunca ayude; sí muestra que, en esa comparación, el gasto adicional no se tradujo en mejores resultados.
Las clasificaciones también dependen del entorno de ejecución —el conjunto de herramientas con el que un agente lee, modifica y ejecuta código—, no únicamente del modelo. En una prueba separada, Qwen3.8-27B obtuvo 75% o 56% en revisiones amplias según el entorno utilizado. El orden relativo entre dos modelos también podía cambiar. Por eso, una tabla que publique solo el nombre del modelo puede ocultar una parte relevante de la configuración evaluada.
Para las empresas que comparan herramientas, la consecuencia práctica es concreta: conviene evaluar el modelo y su entorno como una combinación. También es más informativo comprobar tareas representativas del trabajo propio y medir entregas completas, no quedarse con promedios de criterios.
Qué cambia frente a los benchmarks saturados
Los autores justifican el nuevo test porque varios benchmarks anteriores se han vuelto demasiado fáciles para agentes capaces de ejecutar, comprobar y corregir su propio código. En algunos, esos sistemas superan el 99%, lo que deja poco margen para distinguir modelos. Co-Design Bench busca recuperar ese margen con aplicaciones existentes, instrucciones menos controladas y comprobaciones sobre el resultado en ejecución.
La comparación que presenta The Decoder con WebCompass-edit ilustra la distancia: los modelos de programación agéntica se acercan a resultados casi perfectos en ese benchmark, mientras Co-Design Bench deja una brecha de más de 35 puntos porcentuales. No significa que una única prueba sea la medida definitiva de calidad; muestra que el diseño de la evaluación condiciona qué capacidades quedan visibles.
La cautela también alcanza a las puntuaciones de Co-Design Bench. The Decoder recuerda que un estudio de METR encontró una aceptación real del código generado por IA por parte de responsables de proyectos unos 24 puntos porcentuales por debajo de las puntuaciones de SWE-bench Verified. Es una referencia a la distancia posible entre superar una prueba y que un equipo acepte el resultado, no una conversión directa de la tasa de Co-Design Bench en una tasa de productividad.
El repositorio público del proyecto distingue, además, el experimento completo de un subconjunto preparado para uso público: este último contiene 96 tareas de edición multimodal y 521 criterios, no las 273 tareas del estudio. Sus puntuaciones describen una población distinta y deben identificarse como tal. La separación de los criterios de evaluación respecto de los archivos que recibe el agente también es parte del procedimiento: si el sistema conociera de antemano la rúbrica, la prueba mediría otra cosa.
La lectura más útil para desarrollo no es que los agentes no puedan programar, sino que resolver la mayoría de los puntos de una petición aún queda lejos de cerrar el encargo. En Co-Design Bench, incluso el líder dejó sin completar la mayoría de las tareas evaluadas. Para cualquier compañía que use estas herramientas en aplicaciones existentes, la pregunta inmediata es si sus controles comprueban cada requisito en la aplicación final o si aceptan como terminada una modificación que solo parece casi lista.
Fuentes: The Decoder , arXiv , Hugging Face Papers , GitHub