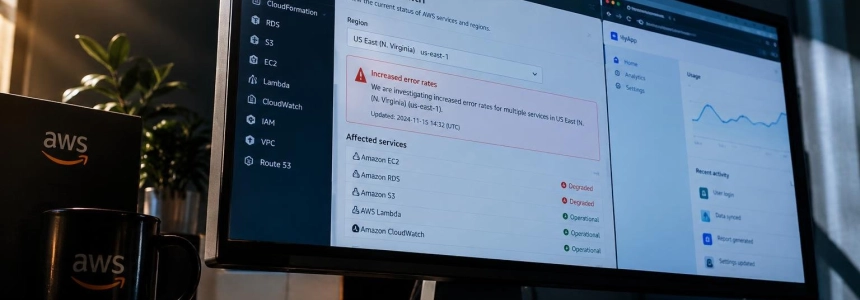
Il 15 novembre, AWS ha riscontrato problemi in undici servizi di us-east-1, tra cui l'autenticazione di IAM Identity Center e una parte dei suoi Network Load Balancers. L'interruzione è durata fino alle 6:21 del mattino, ora del Pacifico, ma ha fatto appena notizia: si è verificata nelle prime ore del mattino sulla costa occidentale degli Stati Uniti e ha interessato soprattutto chi amministra i sistemi, non necessariamente chi usa le applicazioni.
La differenza tra un'interruzione tecnica e una crisi visibile non dipende solo dalla durata. Contano anche l'orario, la funzione interessata e chi ne ha bisogno. In questo caso, parte dei carichi di lavoro ha potuto continuare a funzionare mentre alcuni team non riuscivano ad accedere per gestirli. E i problemi di connettività di un gruppo di bilanciatori non equivalevano a un guasto generale dell'intera regione.
Un'interruzione reale, con due tempi di ripristino
AWS ha rilevato errori di registrazione, autenticazione e connettività in us-east-1 alle 3:05 a. m. PST. Cinque minuti dopo, i suoi ingegneri stavano già lavorando all'incidente, ma il primo avviso pubblico sulla pagina di stato è comparso solo alle 4:38, secondo la cronologia ricostruita da Control Plane. L'avviso di risoluzione è arrivato alle 6:53.
L'episodio non ha avuto un'unica conclusione. L'autenticazione è stata ripristinata alle 5:20; in seguito è rimasto un problema più circoscritto in una parte dei Network Load Balancers di una cella della zona di disponibilità use1-az1. AWS ha indicato le 6:21 come orario di ripristino per quel gruppo. Il suo aggiornamento ha inoltre indicato le 6:10 come termine della finestra principale dell'incidente. Per questo alcuni resoconti parlano di poco più di due ore di problemi di accesso, mentre altri di oltre tre ore di problemi di connettività.
Tra i servizi interessati c'erano IAM Identity Center, AWS Sign Up, Amazon Connect, CloudWatch, NAT Gateway, OpenSearch Service, Step Functions, VPC Lattice, IoT Device Management, Kiro ed Elastic Load Balancing. AWS non ha pubblicato una causa principale. Nei suoi avvisi non ha nemmeno menzionato un attacco informatico.
Il sistema poteva funzionare e, allo stesso tempo, risultare irraggiungibile
IAM Identity Center era la porta d'accesso per gli amministratori che effettuavano l'accesso tramite SSO. Quando quella porta ha smesso di rispondere, i team potevano perdere l'accesso alla console e alle sessioni CLI che dipendevano dalle credenziali SSO; le credenziali già rilasciate continuavano a funzionare fino alla scadenza, secondo Control Plane. L'infrastruttura e l'accesso per gestirla sono due tipi di guasto distinti: un carico di lavoro può continuare a elaborare attività anche se il team di reperibilità non riesce ad accedere tramite il percorso abituale.
Questa distinzione cambia il modo di interpretare le metriche. UptimeRobot ha segnalato che le sue sonde per DynamoDB, S3 e SQS in diverse regioni hanno mantenuto la disponibilità durante il periodo osservato. Non è in contraddizione con l'incidente: quei test non coprivano l'accesso a IAM Identity Center né il gruppo specifico di bilanciatori interessato. Un controllo con esito positivo non rappresenta tutti i percorsi utilizzati da clienti e operatori.
Cambia anche chi si accorge dell'impatto. AWS Support ha dichiarato che non esisteva una soluzione alternativa per i clienti interessati dagli errori di autenticazione. Five Nines ha osservato che i call center che utilizzavano Amazon Connect con agenti autenticati tramite Identity Center potevano perdere l'accesso alle proprie postazioni di lavoro. Il guasto non doveva mettere fuori uso un sito web pubblico per bloccare attività essenziali all'interno di un'azienda.
«la mia app si è appena bloccata; è colpa del mio codice scadente o è in corso un evento globale?»
— The Register, rubrica di opinione
La domanda che The Register pone su Downdetector riassume il ruolo di questi strumenti: gli utenti cercano di distinguere un problema personale da un incidente su vasta scala. Ma l'episodio di AWS non ha generato un'ondata paragonabile di segnalazioni da parte dei consumatori. Il silenzio pubblico non misurava la portata operativa; rifletteva il fatto che il guasto si concentrava sui percorsi di amministrazione e su componenti meno visibili all'utente finale.
Cosa cambia in base al livello interessato
La seconda parte dell'incidente si è concentrata su una frazione degli NLB di una cella in use1-az1. Control Plane spiega che, per impostazione predefinita, ogni nodo di un Network Load Balancer invia il traffico alle destinazioni registrate nella propria zona di disponibilità; il bilanciamento tra zone è disattivato per impostazione predefinita. Se le destinazioni di un'applicazione si trovano solo nella zona interessata, avere istanze integre in un'altra zona non garantisce che ricevano quel traffico.
AWS ha consigliato di creare un nuovo NLB con destinazioni distribuite tra più zone a chi avesse bisogno di una soluzione immediata. Questa risposta presuppone, tuttavia, che ci sia capacità pronta in altre zone e che qualcuno possa effettuare la modifica. La mitigazione dipende da un percorso di accesso indipendente: quella stessa mattina, i problemi di Identity Center potevano impedire agli amministratori di accedere per eseguire l'operazione.
L'architettura deve quindi tenere conto di più di una dipendenza. Control Plane elenca separatamente l'accesso di emergenza, la distribuzione delle destinazioni tra zone, una seconda regione già operativa e il monitoraggio ospitato al di fuori della regione sorvegliata. Non sono soluzioni intercambiabili: una replica regionale non ripristina da sola l'accesso alla console e un metodo di accesso alternativo non sposta il traffico fuori da una zona degradata.
Il costo della preparazione a guasti meno visibili
Control Plane raccoglie diverse opzioni documentate da AWS per mantenere un canale di accesso: federazione diretta con il provider di identità verso singoli account, ruoli o utenti di emergenza, oppure replica di IAM Identity Center in un'altra regione. Secondo l'analisi, la replica richiede una chiave KMS gestita dal cliente e non è disponibile con una sorgente di identità Active Directory. Qualsiasi alternativa deve essere preparata prima dell'incidente e testata: creare ruoli durante il blocco può dipendere dalla stessa console che non è più disponibile.
Per i bilanciatori, la decisione non consiste semplicemente nell'attivare tutte le opzioni. Registrare destinazioni in più zone e abilitare il bilanciamento tra zone modifica la distribuzione del traffico e va valutato in base al carico di lavoro. Control Plane menziona anche il cambio zonale del traffico, disattivato per impostazione predefinita. Una ridondanza efficace richiede capacità e procedure testate, non solo risorse dichiarate in una seconda zona o regione.
La stessa logica vale per gli avvisi. Se la dashboard di stato, le notifiche e le istruzioni di ripristino dipendono dalla regione che si guasta, il team può perdere contemporaneamente sia il servizio sia le informazioni necessarie per intervenire. Control Plane propone di ospitarli al di fuori di quella regione e di mantenere manuali di ripristino che non richiedano SSO. La disponibilità dell'applicazione e la capacità di diagnosticarla sono obiettivi correlati, ma distinti.
Perché AWS è passata inosservata
The Register attribuisce la scarsa risonanza a una combinazione precisa di fattori: era prima dell'alba di domenica sulla costa del Pacifico, il problema di autenticazione interessava soprattutto i professionisti che accedono agli account AWS e, quel giorno, altre interruzioni di Microsoft 365 e del traffico aereo avevano attirato l'attenzione. L'articolo osserva inoltre che Downdetector raccoglie segnalazioni degli utenti e che questo incidente non ha prodotto il tipo di lamentele pubbliche che di solito trasformano un'interruzione in una notizia.
L'articolo solleva un paradosso: le aziende dipendono sempre più da fornitori centralizzati che gestiscono la posta elettronica e altri servizi, ma un guasto isolato può essere scambiato per un problema dei «computer», mentre un'interruzione simultanea per molte organizzazioni attira l'attenzione. La centralizzazione può ridurre il carico di gestione dei sistemi interni, ma fa anche sì che un problema condiviso abbia conseguenze trasversali. In questo caso, tuttavia, l'incidente non si è trasformato in un'interruzione visibile a tutti.
Anche i dati di monitoraggio non raccontano un'unica storia se osservano componenti diversi. UptimeRobot non ha rilevato problemi nelle sue sonde di archiviazione e database; AWS ha invece segnalato errori di autenticazione e connettività in un gruppo di bilanciatori. La visibilità dipende da ciò che si misura: verificare che un'API risponda non dimostra che gli amministratori possano accedere, che ogni zona instradi il traffico o che un'applicazione dipendente da SSO accetti gli utenti.
Cosa possiamo concludere dall'episodio
L'incidente non dimostra che le applicazioni AWS abbiano smesso di funzionare tutte insieme, né AWS ha collegato l'episodio all'interruzione di us-east-1 dell'ottobre 2025. Mostra però che un guasto circoscritto può bloccare le operazioni aziendali senza generare un forte segnale pubblico e che un componente del piano di controllo — l'autenticazione — può essere determinante per la risposta quanto il servizio che esegue il carico di lavoro.
Per i team tecnici, il punto pratico è verificare se riescono ad accedere ed eseguire le proprie procedure quando il metodo di accesso abituale non funziona, oltre a controllare che siano disponibili le destinazioni di rete e la capacità in un'altra zona o regione. AWS non ha spiegato la causa principale dell'incidente del 15 novembre. L'ultima parte della connettività interessata, negli NLB di una cella di use1-az1, è stata ripristinata alle 6:21 a. m. PST.
Fonti: theregister, Five Nines, Control Plane, UptimeRobot