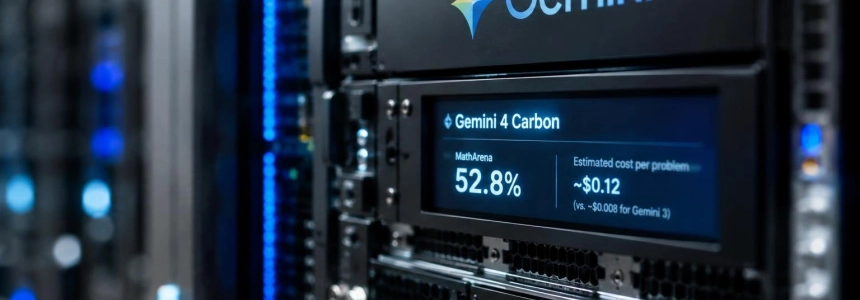
Gemini 4 Carbon encabeza la clasificación de MathArena para razonamiento matemático con un rendimiento estimado del 85,4 % y un coste de 15,70 dólares por problema. GPT-6.1 Sol queda tercero, con un 80,6 % y 1,07 dólares: la mejora estimada es de 4,8 puntos porcentuales, pero Carbon cuesta unas 14,7 veces más por intento.
La clasificación, actualizada por MathArena con los resultados de Gemini 4 Carbon y Claude-Fable-5.2, también muestra que la posición más alta no equivale automáticamente a la mejor opción para cada uso. Carbon supera a Sol en la estimación global, pero el margen convive con un coste muy superior y con resultados que varían bastante según la prueba.
Una ventaja medible, con incertidumbre
MathArena sitúa a Carbon en el primer puesto con un intervalo de 85,4 % ± 3,0 puntos. Claude-Fable-5.2 queda segundo con 82,8 % ± 5,3, y GPT-6.1 Sol tercero con 80,6 % ± 2,7. Los intervalos de Carbon y Sol se solapan; por tanto, la diferencia entre sus estimaciones no describe una victoria idéntica en todas las tareas ni elimina la incertidumbre estadística.
La propia composición de la clasificación importa. MathArena agrega resultados de pruebas disponibles y, cuando un modelo no ha participado en una pregunta concreta, estima su resultado a partir de su rendimiento observado y de las características de esa pregunta. Los modelos no cuentan con los mismos conjuntos de resultados registrados. El porcentaje global, por eso, combina mediciones y estimaciones; no es el resultado de una única prueba compartida en condiciones idénticas.
El coste también es una estimación agregada. MathArena pondera las pruebas por el número de preguntas, deja fuera pruebas retiradas y Project Euler, y estima costes cuando faltan datos. La cifra de 15,70 dólares representa un intento en la mezcla de pruebas considerada, no una tarifa universal para cualquier problema matemático.
La tabla no cuenta toda la historia
La comparación por prueba muestra por qué un único puesto puede ocultar perfiles distintos. En BrokenArXiv de octubre, Carbon aventaja a Sol por 2,47 puntos, mientras que en la edición de septiembre Sol queda ligeramente por delante. En ArXivLean, la diferencia de rendimiento es mucho mayor, pero Carbon también incurre en un coste elevado por problema.
| Modelo y prueba | Rendimiento | Coste por problema |
|---|---|---|
| Carbon, BrokenArXiv de octubre | 82,72 % | 18,06 dólares |
| GPT-6.1 Sol, BrokenArXiv de octubre | 80,25 % | 1,30 dólares |
| Claude-Fable-5.2, BrokenArXiv de octubre | 73,46 % | 39,78 dólares |
| Carbon, BrokenArXiv de septiembre | 82,39 % | 18,60 dólares |
| GPT-6.1 Sol, BrokenArXiv de septiembre | 82,70 % | — |
| Carbon, ArXivLean de septiembre | 62,26 % | 45,11 dólares |
| GPT-6.1 Sol, ArXivLean de septiembre | 35,85 % | 1,16 dólares |
BrokenArXiv plantea afirmaciones plausibles extraídas de conjeturas y otras afirmaciones que trabajos recientes han refutado; el modelo debe evaluar una proposición sin que se le informe de antemano que es falsa. La puntuación premia que la identifique como tal y da cero si afirma haber demostrado una proposición falsa. En ese contexto, el resultado de octubre no solo mide la capacidad de producir una demostración: también pone a prueba si el modelo detecta una premisa incorrecta.
ArXivLean evalúa pruebas formales. En la ronda de septiembre, Carbon alcanzó 62,26 % frente al 35,85 % de Sol. Esa brecha, mucho mayor que la de BrokenArXiv de octubre, puede hacer que Carbon resulte más atractivo para un trabajo de ese tipo, aunque el coste registrado fue de 45,11 dólares por problema frente a 1,16 dólares para Sol.
Más respuestas, más gasto
El coste no se explica solo por el precio base de salida. En la configuración registrada para Carbon y Sol, ambos modelos tienen el mismo precio de salida: 10 dólares por millón de tokens. Sin embargo, en BrokenArXiv de octubre Carbon generó una media de 563.757 tokens de salida por intento, frente a 89.623 de Sol. La diferencia en volumen ayuda a explicar que el gasto por problema sea tan distinto.
Los datos de las pruebas de Carbon también apuntan a un uso intensivo de salida. En ArXivLean de septiembre, MathArena registra 1.064.444 tokens generados y un coste de 45,11 dólares por problema. En BrokenArXiv, los intentos de octubre promediaron 563.757 tokens y 18,06 dólares. No son costes intercambiables: dependen del conjunto evaluado y del trabajo realizado en cada intento.
Esto cambia la lectura práctica para equipos que evalúan modelos. Si el objetivo es maximizar la tasa de aciertos en una tarea matemática exigente, pagar más por Carbon puede tener sentido; si el volumen de consultas es alto y Sol alcanza un resultado suficiente, su menor coste por intento pesa mucho. La comparación relevante no es solo “qué modelo queda primero”, sino cuánto cuesta conseguir el nivel de rendimiento que requiere una aplicación concreta.
Un líder que no siempre termina a tiempo
El rendimiento superior viene acompañado de un límite operativo. The Decoder señala que el modo de fallo más habitual de Carbon en MathArena es superar el tiempo disponible. También indica que casi nunca abandona una tarea: esa persistencia puede ayudar cuando el problema requiere exploración, pero puede consumir recursos sin producir una solución a tiempo.
En un caso, Carbon inició un script que siguió ejecutándose durante más de once horas sin comprobar su progreso. El ejemplo no permite calcular la frecuencia de ese comportamiento, pero sí concreta el tipo de coste que una puntuación media no recoge: además de la facturación por tokens, una ejecución prolongada puede ocupar capacidad y dejar una tarea sin resolver dentro del plazo esperado.
Para desarrolladores, la consecuencia es que un benchmark de razonamiento y una evaluación de producto responden a preguntas diferentes. MathArena mide el desempeño en problemas matemáticos bajo su protocolo; la experiencia de una aplicación también depende de que el modelo termine dentro del tiempo permitido y de que el gasto por intento sea asumible.
Elegir por tarea, no por medalla
La comparación entre los tres primeros ilustra el intercambio. Carbon logra el mejor resultado global y supera a Sol en BrokenArXiv de octubre, pero en septiembre Sol queda por delante. Fable 5.2 se coloca segunda en la clasificación agregada, aunque sus 40,20 dólares estimados por problema la hacen aún más cara que Carbon; en BrokenArXiv de octubre registra 73,46 % y 39,78 dólares.
MathArena también publica resultados por rondas y permite inspeccionar trazas de respuestas. Para una empresa que esté considerando estos modelos, esa granularidad resulta más útil que trasladar sin más el ranking a producción: una tarea parecida a ArXivLean favorece una conclusión distinta de una evaluación centrada en BrokenArXiv, y la estimación global no sustituye la medición del coste en el conjunto de problemas que se vaya a utilizar.
La noticia, por tanto, no es simplemente que Google haya desplazado a OpenAI de la primera posición. Es que Carbon obtiene una ventaja estimada y específica en matemáticas a cambio de más tokens, mayor coste y un riesgo de exceder el tiempo de ejecución. La pregunta para cada equipo es cuánto vale esa mejora en su carga real de trabajo y si puede tolerar el coste de los intentos que no terminan a tiempo.
Fuentes: The Decoder, MathArena, MathArena, AI Ping