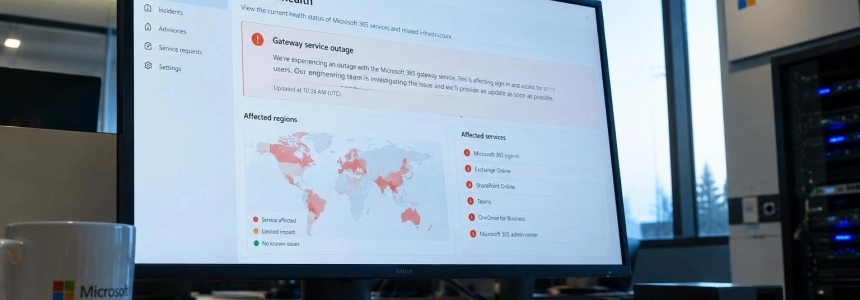
Más del 80% de los servidores de red afectados dejó de responder durante la caída global de Microsoft 365 del 12 y 13 de noviembre. Microsoft atribuye el incidente, que duró casi 24 horas, a un defecto de Windows introducido en una actualización de julio para sus propias puertas de enlace, agravado por un aumento de carga y una reducción temporal de capacidad.
El impacto más fuerte se concentró en Exchange Online: muchos usuarios no podían acceder a sus buzones, y el envío y la recepción de correo se retrasaron. Teams, Copilot, SharePoint y OneDrive también registraron fallos en las funciones que dependen de Exchange. La interrupción varió según la región, el momento y el método de conexión.
Un defecto latente desde julio
El informe preliminar de Microsoft, fechado el 15 de noviembre, señala tres factores que coincidieron. El primero fue un defecto introducido al desplegar en julio una actualización para los servidores de puerta de enlace de red de Microsoft 365. La compañía afirma que la modificación se extendió gradualmente por todo el mundo y funcionó durante más de tres meses sin incidentes visibles.
El fallo aparecía bajo determinadas cargas. La disputa entre tareas por un bloqueo compartido dentro de un proceso interno de Windows —un problema conocido como contención de bloqueos— podía agotar los recursos de CPU y memoria y dejar la máquina sin respuesta. La anomalía era más probable en hardware moderno con más núcleos, pero las pruebas de carga de Microsoft se centraban en equipos menos potentes y con menos núcleos.
La actualización estaba preparada específicamente para los servidores de red de Microsoft 365. Microsoft aclaró que no afecta a otras instalaciones de Windows. Esa precisión distingue este incidente de un defecto general de Windows Server: el problema estaba vinculado a la ruta de código de las puertas de enlace de Microsoft 365, no a todos los servidores que ejecutan Windows.
El tráfico adicional desencadenó el fallo en cascada
El segundo factor fue un cambio de ruta de tráfico. Unas 15 horas antes de la caída, el tráfico de Teams pasó automáticamente de una puerta de enlace alternativa a la principal, que también da servicio a Exchange Online. Microsoft describió el cambio como una operación normal, pero elevó la carga en la infraestructura afectada.
Además, casi el 14% de la capacidad de los servidores de la puerta de enlace estaba fuera de servicio por un problema independiente ocurrido el día anterior. La capacidad debía volver mediante tareas rutinarias; por separado, Microsoft consideraba que el sistema aún tenía margen suficiente. El aumento de carga y la capacidad reducida, al coincidir, llevaron a los servidores a las condiciones que activaban el defecto.
Cuando una máquina quedaba sin respuesta, los sistemas automáticos desviaban las solicitudes hacia servidores que seguían operativos. Pero estos recibían más tráfico y podían caer por el mismo fallo. En menos de dos horas, la anomalía se había propagado por la infraestructura: en el peor momento, más del 80% de los servidores no respondía.
Las barreras que debían mantener el impacto dentro de componentes o regiones no impidieron que se extendiera a escala global. El informe preliminar identifica un problema separado que afectó a esas protecciones, aunque no detalla por completo qué lo causó. La diferencia entre servicios también influyó en la duración: Teams, OneDrive, SharePoint y las aplicaciones de Office podían salir de la infraestructura defectuosa; Exchange Online no podía hacerlo por razones de escala.
Por qué la recuperación se prolongó
Reiniciar servidores no bastaba. Al volver a recibir el tráfico acumulado, algunas máquinas volvían a quedar bloqueadas. Los procesos automáticos habituales no estaban diseñados para recuperar una caída tan amplia, y las opciones normales de reversión tampoco podían retirar con rapidez un cambio que llevaba meses desplegado.
Microsoft identificó la negociación de conexiones como el principal cuello de botella entre las 00:30 y la 01:00 UTC del 13 de noviembre. A las 07:20 UTC aplicó una mitigación: una actualización que devolvía la ruta de gestión de conexiones a un estado de código que ya había funcionado. Después, los equipos retiraron servidores por grupos, aplicaron el cambio, los reiniciaron y los devolvieron gradualmente al servicio.
La compañía también desvió tráfico por rutas alternativas, añadió capacidad y amplió el plazo de entrega del correo para evitar que los mensajes en cola se devolvieran como no entregables. La recuperación avanzó por regiones: Asia-Pacífico comenzó a restablecerse parcialmente alrededor de las 11:00 UTC y Europa, a las 11:35. La disponibilidad global del correo web volvió a los niveles esperados a las 14:17.
Microsoft dio por terminado el impacto activo a las 16:10 UTC del 13 de noviembre, aunque siguió supervisando el servicio y vaciando la cola de correo. Emitió las últimas actualizaciones para clientes a las 04:15 UTC del día 14. En su informe preliminar señala que los mensajes acumulados se procesaron.
Microsoft descarta un ataque y prepara más medidas
La empresa describió el incidente como un fallo técnico, sin indicios de actividad maliciosa. También negó que la caída estuviera relacionada con los despidos anunciados el mes anterior o con la sustitución de empleados por sistemas de IA.
Charles Lamanna, responsable de Copilot, Agents y Platform en Microsoft, reconoció la dimensión del fallo en declaraciones difundidas en X.
“In less than two hours, the previously unknown defect was encountered across our fleet and rendered them unresponsive. At its lowest, more than 80% of servers were unresponsive.”
— Charles Lamanna, responsable de Copilot, Agents y Platform en Microsoft
Microsoft afirma haber añadido capacidad, ampliado la supervisión del tráfico y de la gestión de conexiones e incorporado límites para reducir el riesgo de que una redistribución de tráfico provoque otra caída en cascada. También extendió el plazo de entrega del correo y confirmó que los mensajes en espera se procesaron.
La investigación sigue abierta. Microsoft prevé publicar el informe final el 20 de noviembre de 2026, con el listado completo de medidas correctivas. Ese documento deberá ampliar los detalles sobre las causas y las protecciones que no contuvieron la propagación.
Fuentes: Wccftech, 9to5Mac, XDA, theregister, The Stack, 365Fanatic