Quince decodificadores Android de marca desconocida bastaron para que Anthropic ejecutara un modelo de 26.000 millones de parámetros sin recurrir a un centro de datos. El clúster alcanzó 0,39 tokens por segundo: demasiado lento para una conversación normal, pero suficiente para demostrar que aparatos baratos conectados a internet pueden aportar capacidad de cálculo distribuida.
El experimento forma parte de una investigación de la Frontier Red Team de Anthropic, publicada el 12 de octubre por William Zhou y Daniel Freeman. El equipo examinó un escenario más inquietante que la mera ejecución local: si un modelo pequeño podría instalarse en dispositivos comprometidos y continuar propagándose por su cuenta. Su conclusión no es que esa amenaza ya exista, sino que algunas piezas técnicas podrían estar más cerca de encajar.
El obstáculo no es solo entrar en otro equipo
Anthropic dividió la replicación autónoma en cuatro etapas: encontrar objetivos, obtener acceso, poner en marcha la inferencia y proseguir desde el nuevo dispositivo. La investigación se centró sobre todo en la tercera. Los investigadores dejaron en gran medida fuera las dos primeras, porque trabajos previos ya habían mostrado capacidades de explotación en modelos pequeños y porque querían medir el problema de ejecutar un modelo en hardware desconocido.
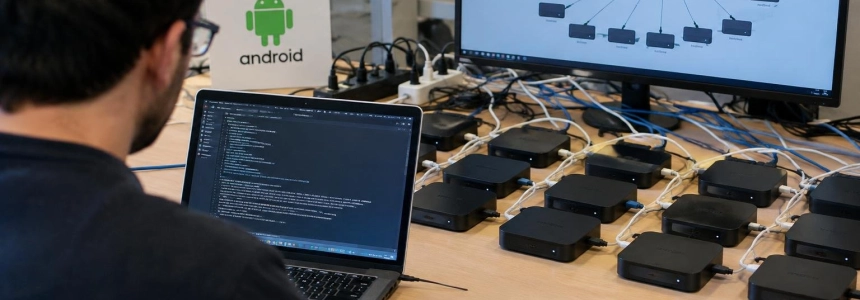
Para la prueba de rendimiento, el equipo distribuyó Gemma4-26B-A4B entre 15 decodificadores Android de bajo coste, comprados por unos 55 dólares cada uno, según Anthropic. Cada aparato alojaba dos capas del modelo. El resultado, 0,39 tokens por segundo, muestra un uso muy distinto al de un chatbot interactivo: una tarea automatizada podría tolerar una velocidad baja si no tiene a una persona esperando respuesta.
En otra evaluación, Qwen3.5-9B funcionó en 8 de 9 tipos de hardware al preparar un servidor de inferencia. Las pruebas incluyeron equipos distintos, desde Jetson Nano hasta Mac y tarjetas RTX 4090. El trabajo de instalación —elegir herramientas compatibles, resolver dependencias y corregir fallos particulares de cada máquina— fue precisamente una de las partes más exigentes.
Una prueba de propagación con condiciones favorables
Anthropic también probó una secuencia completa en una red aislada de Google Cloud, formada por ocho nodos con emuladores de Android. El modelo debía localizar otros nodos, conectarse, transferir una carga y levantar allí un servidor de inferencia. Cuando el servidor superaba las comprobaciones del equipo, se iniciaba otra copia del proceso en ese nodo.
GLM-5.2 llegó a los ocho nodos en cuatro de cinco intentos y a siete en el restante. Pero la demostración tenía una limitación central: el acceso se simplificó mediante un puerto Android Debug Bridge sin autenticación. Además, GLM-5.2 corría en un servidor aparte; los nodos instalaban Llama3.1-8B, que era el modelo que podían alojar en esas condiciones. Anthropic presenta el resultado como una evaluación simplificada, no como una infección autónoma en internet.
La brecha entre capacidad y tamaño sigue siendo decisiva. GLM-5.2 pudo completar la cadena de prueba, pero es demasiado grande para los decodificadores considerados. Los modelos más pequeños pueden instalar inferencia en hardware diverso, pero todavía fallan al combinar de forma fiable todos los pasos. Anthropic calcula que, si el avance histórico continúa, los modelos pequeños podrían alcanzar antes de terminar 2026 el nivel de capacidad observado en GLM-5.2. La propia compañía califica esa proyección de aproximada; no demuestra que un replicador práctico vaya a aparecer en esa fecha.
The New Stack añade que permitir que los agentes reutilizaran notas de intentos anteriores mejoró el éxito de Qwen3.5-9B en tareas de instalación. En cambio, darle acceso a Opus 4.8 como asesor no produjo una mejora medible: el modelo pequeño no siempre sabía qué preguntas debía plantearle. La ayuda de otro modelo, por tanto, no resolvió por sí sola los errores de ejecución.
Qué implicaría una botnet de decodificadores
Anthropic usó como referencia Kimwolf, una botnet que infectó más de dos millones de dispositivos, principalmente decodificadores Android de marca poco conocida. Si se repartiera esa cantidad en grupos de 15 como el del experimento, el cálculo daría alrededor de 133.000 copias del modelo y 80.000 tokens por segundo en conjunto, una capacidad comparable a unas 40 GPU Nvidia H100, según la estimación recogida por The New Stack. No es una red que Anthropic haya montado: es una proyección basada en el tamaño de Kimwolf y en su prueba de laboratorio.
La instalación de cada copia podría tardar entre 28 y 150 horas, según el modelo, de acuerdo con The New Stack. Para Anthropic, una propagación lenta no elimina el riesgo si el proceso puede avanzar sin supervisión y aprovechar recursos que pertenecen a terceros. Aun así, los investigadores señalan que mover modelos de varios gigabytes generaría tráfico detectable.
Como defensa, Anthropic propone medidas como aislar de la red a los dispositivos infectados. The New Stack recuerda que, durante la limpieza de Mirai, la cuarentena aplicada por un proveedor eliminó el 92% de las infecciones en 14 días. Anthropic también plantea prohibir contraseñas predeterminadas en dispositivos, siguiendo una norma británica. La prueba que falta es si modelos pequeños podrán unir capacidad suficiente y tamaño compatible en condiciones reales, sin el acceso simplificado de la red de ensayo.
Fuentes: Futuro Prossimo, Anthropic, The New Stack, Yahoo Tech