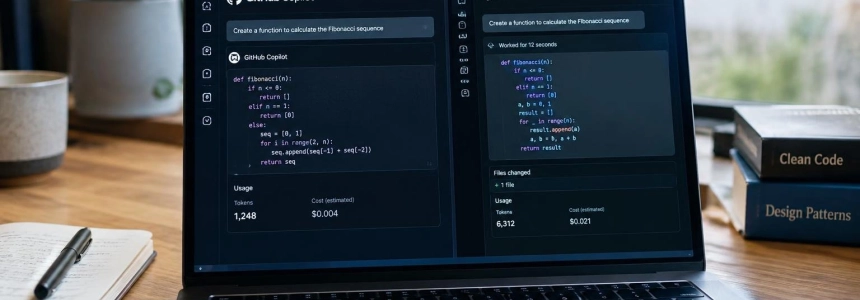
A parità di modello e di attività, Aider in modalità architetto ha richiesto circa 3.500 token per attività risolta; OpenClaw, 292.000. Un altro benchmark ha rilevato che il costo per attività poteva variare fino a 13,1 volte tra harness. Il modello non è l’unica variabile che determina quanto costa un agente di programmazione.
Un harness è il livello che dirige il ciclo dell’agente: invia richieste al modello, gestisce la cronologia, chiama gli strumenti e decide quando terminare. The New Stack ha confrontato diversi sistemi di questo tipo mantenendo fissi modelli e attività; in uno studio successivo, anche Composio ha isolato l’effetto dell’harness. I dati non costituiscono una classifica universale: si riferiscono a insiemi di test diversi e mostrano risultati che cambiano a seconda del modello.
Il costo inizia prima che l’agente si metta al lavoro
In uno dei test riportati da The New Stack, ogni harness ha ricevuto le stesse attività tramite OpenRouter e con lo stesso modello. La differenza più evidente è emersa prima ancora che l’agente affrontasse il lavoro: il sistema aggiungeva istruzioni, descrizioni degli strumenti e dati dell’ambiente. Il benchmark ha definito questa spesa iniziale «startup tax».
Questo blocco occupava circa 700 token in Aider, in modalità architetto, rispetto ai circa 26.000 di OpenClaw. Poiché il contesto viene inviato di nuovo a ogni turno, non si tratta necessariamente di un costo pagato una sola volta. Nel calcolo dell’articolo, ripetere 26.000 token per quindici turni equivale a quasi 390.000 token di input solo per quel testo di configurazione.
In quel test, il costo di avvio moltiplicato per il numero di turni ha previsto i token per attività risolta con un R² di 0,99 nei due modelli provati. Al contrario, la crescita di quel blocco a ogni turno non ha spiegato la differenza: ciascun harness aggiungeva alcune centinaia di token per turno. Il volume iniziale e il numero di volte in cui viene elaborato sono quindi variabili che il team può osservare e modificare senza sostituire il modello.
Il confronto tra 3.500 e 292.000 token misura il consumo per attività risolta. In un’altra valutazione, Composio ha rilevato differenze fino a 13,1 volte nel costo per attività, a seconda del modello e dell’insieme di test.
Costo, successo e tempo non sempre variano insieme
Composio ha mantenuto fissi il modello, l’insieme di attività e il catalogo degli strumenti durante il confronto tra harness. Con DeepSeek V4 Pro, nove opzioni hanno completato dal 30% al 60% di una batteria di 30 attività; il costo per attività variava da 0,101 a 0,252 dollari. In una seconda valutazione con GPT-6 Astra, sei harness hanno raggiunto un tasso di successo dal 66% al 72%, con costi da 1,20 a 15,72 dollari per attività.
| Modello e test | Harness | Successo osservato | Costo per attività |
|---|---|---|---|
| DeepSeek V4 Pro, 30 attività | 9 | 30%-60% | 0,101-0,252 dollari |
| GPT-6 Astra, 29 casi condivisi | 6 | 66%-72% | 1,20-15,72 dollari |
Nel secondo test, cinque dei sei sistemi si sono collocati in una fascia compresa tra 1,20 e 1,63 dollari. Claude Code è stato il valore anomalo, con 15,72 dollari per attività, il maggior consumo di token —1,547 milioni— e il tempo medio più lungo, 194 secondi. Tuttavia, si è classificato quarto per successo, con il 69%. Questo dato mostra perché confrontare soltanto il prezzo o soltanto il tasso di successo può nascondere il comportamento effettivo del sistema.
I risultati non consentono neppure di trasferire senza riserve un vincitore da un modello all’altro. Tra i sei harness presenti in entrambi i test, l’ordine è cambiato; Pi Agent, per esempio, è arrivato a pari merito al secondo posto con DeepSeek e al quinto con GPT-6 Astra. Composio avverte che sei confronti non bastano per stabilire se le classifiche tra modelli siano correlate.
I turni e la cache modificano il conto
Il numero di turni incide perché ogni richiesta rielabora la cronologia accumulata, compresi i risultati degli strumenti e gli schemi. Composio ha provato tre modalità per fornire istruzioni di pianificazione con Sonnet 4.5 e lo stesso harness. Caricando la pianificazione come competenza richiamabile, il sistema ha usato il 33,4% di token in meno rispetto alla configurazione senza pianificazione, mantenendo lo stesso 100% di successo in quella batteria di undici casi.
Il test ha registrato anche il 21,5% di turni in meno e il 21,8% di tempo in meno. Ma la batteria raggiungeva già il 100% di successo senza pianificazione, quindi non consente di concludere se questa strategia sia utile per attività più difficili. La pianificazione inserita direttamente nel prompt ha perso un caso; il risultato favorevole riguarda la variante che la offriva come competenza.
La cache può modificare il costo anche quando il consumo lordo di token sembra sfavorevole. Nel test di Composio, Claude Code ha ottenuto dalla cache l’1,5% dei suoi token di input; Codex, circa il 70%, e OMP, il 57%. L’input nuovo costava quasi cinque volte più di quello servito dalla cache, perciò Codex è risultato più economico per attività rispetto a un harness che ha usato la metà dei token senza cache.
È importante fare attenzione nell’attribuire questa differenza. The New Stack ha collegato la bassa percentuale di cache di Claude Code al percorso delle sue richieste attraverso OpenRouter e alla conversione di un formato di messaggi, non al testo delle sue istruzioni. In quell’esecuzione era l’unico harness a usare l’endpoint di messaggi in stile Anthropic attraverso il gateway. È un risultato relativo a quel percorso di integrazione, non una proprietà del prodotto dimostrata in qualsiasi configurazione.
Anche gli strumenti disponibili cambiano il risultato
L’harness non opera in isolamento: i collegamenti alle applicazioni determinano quali azioni l’agente può tentare. In undici confronti tra connettori, Composio ha registrato un tasso di completamento del 99% contro una media dell’86% per le opzioni native —server MCP, CLI o connettori proprietari—. La media riassume risultati disomogenei: sette test hanno favorito Composio, due si sono conclusi in parità e due hanno favorito l’alternativa.
Slack è stato il caso più evidente. Il server MCP proprietario poteva tentare 18 attività su 50; Composio le ha tentate tutte e 50 e ne ha completate correttamente il 94%. La prima integrazione ha risolto tutti i casi che era in grado di eseguire, ma la sua copertura era limitata. La seconda ha coperto più attività con un tasso di successo inferiore al 100%. Per un’azienda, la differenza tra copertura e successo è importante: una percentuale aggregata potrebbe non descrivere l’insieme di azioni di cui il team ha bisogno.
Esistono differenze anche tra accessibilità ed efficienza. In un confronto tra gateway, Composio ha ridotto i turni del 41%, le chiamate al provider del 52% e il tempo totale del 50% rispetto al gateway MCP di Zapier; l’uso dei token è diminuito del 18%. In un altro test, il caricamento differito degli schemi ha ridotto del 68% i token di Arcade, senza aumentare il suo tasso di successo. Risparmiare token non garantisce, da solo, che più attività vengano completate correttamente.
Cosa dovrebbero misurare i team
Per un’azienda che utilizza agenti su larga scala, scegliere un modello in base al prezzo pubblicizzato non tiene conto dei costi che dipendono dall’esecuzione. Le evidenze indicano di misurare separatamente, sulle proprie attività, le dimensioni del contesto fisso, il numero medio di turni, il tasso di successo, il tempo, i token e la percentuale servita dalla cache. È inoltre opportuno verificare quali attività ogni connettore può effettivamente tentare.
Il repository di benchmark di GitHub incluso tra le fonti propone di creare test con attività tratte da repository reali, fissare i riferimenti del codice, registrare costo, latenza e turni e valutare i risultati con un valutatore indipendente. Il suo stesso insieme ha pubblicato un esempio di instradamento tra modelli: su 21 attività, è risultato più economico del 45,4%, con una qualità inferiore del 4,6%. È un compromesso misurato in quell’insieme, non una garanzia per altri team.
I limiti dei test suggeriscono di non trasformare i loro dati in una classifica permanente dei vincitori. La valutazione di giugno di The New Stack ha eseguito un solo passaggio per harness, attività e modello, senza stime della variabilità; inoltre, gli agenti possono produrre risultati stocastici. Composio, dal canto suo, ha segnalato che alcuni costi sono stati registrati solo in una parte dei casi e che una configurazione utilizzava parametri di ragionamento diversi.
La conclusione operativa non è che un determinato harness sia sempre più economico, ma che fa parte del costo e delle prestazioni dell’agente. Il divario nei token può nascere nel messaggio iniziale, crescere a ogni turno e cambiare con la cache; anche il tasso di successo può variare, e l’ordine dei sistemi non si mantiene necessariamente quando si cambia modello. Il passo successivo per un team è verificare queste metriche sui propri flussi di lavoro.