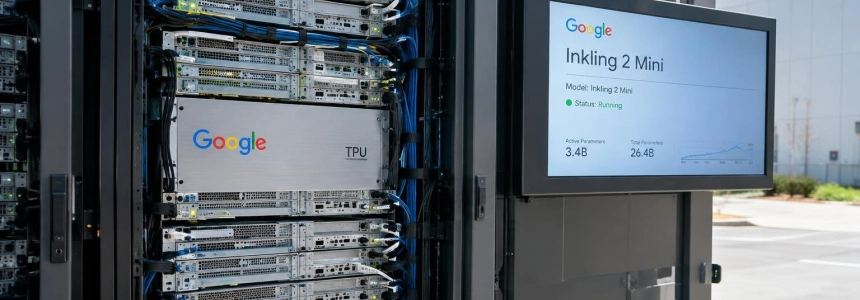
Inkling 2 Mini ha 26,4 miliardi di parametri totali e 3,4 miliardi attivi, ma esegue i suoi strati centrali tre volte per token. Il modello a pesi aperti, pubblicato da Thinking Machines Lab, mira ad avvicinare le prestazioni di sistemi più grandi ai dispositivi locali.
Il nome può trarre in inganno, ma identificare correttamente il modello è importante per valutare il lancio: il fornitore è Thinking Machines Lab. La scheda del modello indica che è stato pubblicato il 20 novembre 2026 con licenza Apache 2.0 e che i suoi pesi sono disponibili per la ricerca, il fine-tuning e l'integrazione nei prodotti di terze parti. La proposta tecnica non consiste soltanto nel ridurre le dimensioni: cambia il modo in cui il calcolo viene distribuito durante la generazione.
Più lavoro interno con gli stessi strati
Inkling 2 Mini è un trasformatore multimodale a 24 strati, con architettura Mixture-of-Experts. I primi sei e gli ultimi sei vengono eseguiti una volta; i 12 strati centrali vengono attraversati tre volte, riutilizzando gli stessi pesi. Ogni token passa così attraverso 48 applicazioni di strati, anche se il modello memorizza solo 24 strati distinti.
I passaggi non sono copie indipendenti. Secondo la descrizione tecnica di Thinking Machines Lab, ciascuno parte dall'output del primo blocco e riceve messaggi appresi dal passaggio precedente. Questo meccanismo permette agli strati centrali di affinare il calcolo senza esprimere ogni passaggio sotto forma di testo di ragionamento. L'azienda sostiene che questa ripetizione migliori soprattutto le attività che richiedono di concatenare più passaggi, come la programmazione agentica.
Il modello attiva otto esperti su 128 per strato. Il numero di parametri attivi dipende da come si conteggia il costo aggiuntivo dovuto alla ripetizione: Thinking Machines Lab indica 3,4B attivi e 5,4B includendo le attivazioni del loop, mentre Hugging Face riassume il modello come dotato di circa 3B parametri attivi e la scheda di vLLM ne indica 3,5B. Anche il numero totale di parametri è arrotondato in queste pagine.
La distinzione pratica è che «pochi parametri attivi» non equivale a «poco calcolo per token». Nei test di servizio pubblicati da vLLM, ogni passaggio aggiuntivo aumenta il tempo di decodifica e riduce la capacità disponibile per la cache. Nel test con una GB200 e un contesto di 4K, il passaggio di decodifica con batch 1 è salito da 1,51 millisecondi con un passaggio a 3,85 millisecondi con tre.
Cosa mostrano i risultati e cosa no
Thinking Machines Lab colloca Inkling 2 Mini davanti a modelli aperti comparabili in diversi test di programmazione. In DeepSWE v1.1 ha ottenuto il 48,2 %, contro il 42,2 % di Qwen3.8-27B; in SWE-bench Pro v2 Hard, la tabella dell'azienda riporta 77,9 % contro 73,8 %. Si tratta di risultati riportati dal fornitore stesso, che dipendono dai metodi e dagli strumenti usati in ciascuna valutazione.
Il confronto non si traduce in una vittoria su tutti i fronti. Qwen3.8-27B supera Inkling 2 Mini in Terminal Bench v2.1 e AutomationBench-AA; ottiene inoltre risultati migliori in AA-Omniscience, una valutazione della conoscenza fattuale. Il loop favorisce il ragionamento, ma non aggiunge fatti ai pesi: Thinking Machines Lab afferma che la capacità di richiamare informazioni resta vicina a quella di altri modelli di dimensioni simili.
| Valutazione | Inkling 2 Mini | Qwen3.8-27B | Interpretazione |
|---|---|---|---|
| DeepSWE v1.1 | 48,2 % | 42,2 % | Vantaggio di Inkling |
| SWE-bench Pro v2 Hard | 77,9 % | 73,8 % | Vantaggio di Inkling |
| Terminal Bench v2.1 | 71,6 % | 73,0 % | Vantaggio di Qwen |
| AutomationBench-AA v1.0.6 | 41,8 % | 48,2 % | Vantaggio di Qwen |
| AA-Omniscience, punteggio | -8,6 | -6,4 | Vantaggio di Qwen |
Si distingue anche nelle attività di ricerca e uso di strumenti: Thinking Machines Lab riporta il 79,0 % in BrowseComp e l'85,3 % in DeepSearchQA. Questa combinazione può compensare in parte i limiti della conoscenza interna, a condizione che l'applicazione disponga di strumenti affidabili. Non significa che il modello ricordi meglio le informazioni: significa che può ottenere risultati migliori quando ha i mezzi per cercarle.
La scheda tecnica indica inoltre l'accettazione di testo e immagini in ingresso e una finestra di contesto fino a un milione di token. Il file misto NVFP4 e MXFP8 occupa circa 20 GB; l'azienda segnala la compatibilità con sistemi Mac dotati di almeno 32 GB di memoria e con DGX Spark. Le dimensioni ne facilitano la prova in locale, ma non eliminano le differenze di velocità tra hardware e runtime.
Il costo della ripetizione
L'architettura mira a ridurre il numero di pesi memorizzati, non a rendere gratuito il ragionamento aggiuntivo. Nelle misurazioni di vLLM con una GB200, il passaggio di decodifica con batch 1 è stato di 1,51 ms con un passaggio, 2,67 ms con due e 3,85 ms con tre. La capacità della cache KV è scesa da 352.000 token a 233.000 e 175.000, rispettivamente.
Nei test di vLLM, un maggior numero di passaggi ha aumentato il tempo di decodifica e ridotto la capacità della cache KV. Per i carichi con molte richieste simultanee, questi valori aiutano a dimensionare il servizio sull'hardware testato; la capacità della cache può limitare il numero di sessioni gestibili da una GPU. Nella sua variante di ricerca, vLLM permette di condividere la cache KV tra i passaggi, anche se nei test la capacità è salita da 175.000 a 194.000 token, senza raggiungere il livello di un singolo passaggio.
Il modello principale usa un numero fisso di passaggi. Thinking Machines Lab pubblica anche TML-d24-varloop-research, che permette di variarli; Hugging Face e vLLM descrivono come configurare uno, due o più passaggi. Meno passaggi velocizzano la generazione, con una possibile perdita di qualità, mentre più passaggi ne aumentano il costo. La modalità a loop variabile trasforma questo equilibrio in una scelta di configurazione, anziché in una caratteristica che si può ignorare.
Accesso locale e lavoro di integrazione
I pesi aperti permettono ai team di valutare il modello senza dipendere esclusivamente da un servizio ospitato. Thinking Machines Lab elenca opzioni come Ollama, llama.cpp, vLLM e SGLang; Hugging Face aggiunge il supporto in Transformers e MLX. vLLM ha annunciato il supporto dal primo giorno per Blackwell, Hopper e DGX Spark. La disponibilità su più runtime riduce il costo iniziale, ma l'integrazione richiede comunque di verificare la compatibilità e le prestazioni nell'ambiente specifico.
Per un prodotto di programmazione assistita, i risultati di DeepSWE o SWE-bench possono giustificare un confronto su attività reali del team. Per un'applicazione basata sulla conoscenza, invece, il risultato fattuale e la capacità di seguire istruzioni complesse meritano maggiore attenzione: Inkling 2 Mini è rimasto indietro rispetto a Qwen3.8-27B in MultiChallenge e ComplexConstraints. Thinking Machines Lab riconosce inoltre limiti nelle conversazioni su più turni e nelle attività con molti vincoli.
Hugging Face avverte che il modello può bloccarsi in cicli di ragionamento, soprattutto durante il debug del codice, e consiglia di limitare i token in uscita e i turni dell'agente. Segnala inoltre che un agente può eliminare o sovrascrivere file senza chiedere conferma. Nei sistemi che usano strumenti, il costo di un errore supera quello di una risposta imprecisa; la scheda raccomanda sandbox, conferma per le azioni irreversibili e una valutazione interna prima della distribuzione.
Ragionamento meno visibile, supervisione ancora discussa
La ripetizione solleva una questione distinta dalle prestazioni: una parte del calcolo avviene all'interno del modello e non compare nella catena di pensiero che un monitor può leggere. Nella variante di ricerca, secondo le misurazioni di Thinking Machines Lab, l'orizzonte delle attività risolte dal modello senza catena di pensiero è passato da 16 secondi con un passaggio a 37 con tre. In un'attività di concatenazione di ricerche, le prestazioni hanno continuato a migliorare fino a dieci passaggi.
Nei suoi esperimenti, l'azienda non ha rilevato una chiara riduzione della leggibilità della catena di pensiero. Con cinque passaggi, il ragionamento medio in un sottoinsieme di domande era di 1.661 token, contro 3.703 con un passaggio; gli indicatori di leggibilità riportati sono rimasti simili. Tuttavia, questo non dimostra che il ragionamento interno sia osservabile: la stessa spiegazione riconosce che i processi non verbalizzati non possono essere rilevati da un monitor della catena di pensiero.
Nei test di attività agentiche, Thinking Machines Lab non ha osservato una chiara tendenza a un maggior sabotaggio occulto all'aumentare dei passaggi. La scheda afferma inoltre che il modello non è riuscito a eseguire attività laterali occulte in ambienti agentici realistici. L'azienda chiede ulteriori ricerche sulla supervisione dei modelli ricorrenti; per ora, i risultati sono preliminari e specifici di questi test, non una garanzia di sicurezza per qualsiasi flusso di lavoro.
Inkling 2 Mini offre un'alternativa aperta che combina esecuzione locale, costi di archiviazione moderati e buoni risultati in alcune attività di programmazione e ricerca. Il compromesso è un maggior calcolo per token, prestazioni variabili tra piattaforme e limiti nella conoscenza fattuale e nella gestione di istruzioni complesse. Per chi lo valuta, la domanda concreta non è se possa sostituire in astratto un modello più grande, ma se i vantaggi per la propria attività compensino i passaggi aggiuntivi e le misure di protezione richieste.
Fonti: Thinking Machines Lab, Hugging Face, Hugging Face, vLLM