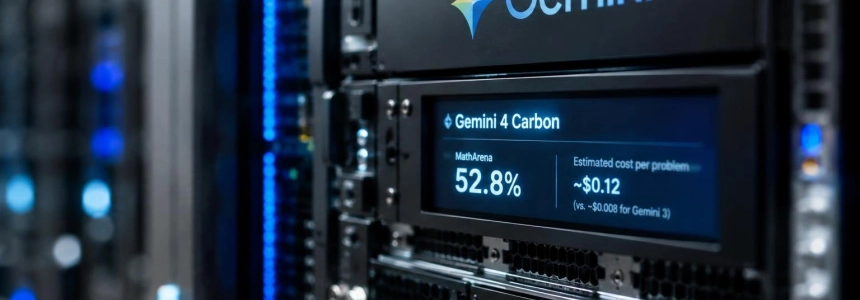
Gemini 4 Carbon è in testa alla classifica di MathArena per il ragionamento matematico con una prestazione stimata dell’85,4% e un costo di 15,70 dollari per problema. GPT-6.1 Sol è terzo, con l’80,6% e 1,07 dollari: il miglioramento stimato è di 4,8 punti percentuali, ma Carbon costa circa 14,7 volte di più per tentativo.
La classifica, aggiornata da MathArena con i risultati di Gemini 4 Carbon e Claude-Fable-5.2, mostra anche che la posizione più alta non equivale automaticamente alla scelta migliore per ogni utilizzo. Carbon supera Sol nella stima complessiva, ma il margine si accompagna a un costo molto più elevato e a risultati che variano considerevolmente a seconda della prova.
Un vantaggio misurabile, con un margine d’incertezza
MathArena colloca Carbon al primo posto con un intervallo di 85,4% ± 3,0 punti. Claude-Fable-5.2 è secondo con l’82,8% ± 5,3, mentre GPT-6.1 Sol è terzo con l’80,6% ± 2,7. Gli intervalli di Carbon e Sol si sovrappongono; pertanto, la differenza tra le loro stime non descrive una vittoria uniforme in tutte le attività né elimina l’incertezza statistica.
Conta anche la composizione stessa della classifica. MathArena aggrega i risultati delle prove disponibili e, quando un modello non ha partecipato a una determinata domanda, ne stima il risultato sulla base delle prestazioni osservate e delle caratteristiche di quella domanda. I modelli non dispongono degli stessi risultati registrati. La percentuale complessiva, quindi, combina misurazioni e stime; non è il risultato di un’unica prova condivisa e svolta in condizioni identiche.
Anche il costo è una stima aggregata. MathArena pondera le prove in base al numero di domande, esclude le prove ritirate e Project Euler e stima i costi quando mancano i dati. La cifra di 15,70 dollari rappresenta un tentativo nell’insieme di prove preso in considerazione, non una tariffa universale per qualsiasi problema matematico.
La tabella non racconta tutta la storia
Il confronto tra le singole prove mostra perché un’unica posizione in classifica possa nascondere profili diversi. Nella BrokenArXiv di ottobre, Carbon è avanti a Sol di 2,47 punti, mentre nell’edizione di settembre Sol è leggermente in vantaggio. In ArXivLean, la differenza di prestazioni è molto più ampia, ma anche il costo per problema di Carbon è elevato.
| Modello e prova | Prestazione | Costo per problema |
|---|---|---|
| Carbon, BrokenArXiv di ottobre | 82,72% | 18,06 dollari |
| GPT-6.1 Sol, BrokenArXiv di ottobre | 80,25% | 1,30 dollari |
| Claude-Fable-5.2, BrokenArXiv di ottobre | 73,46% | 39,78 dollari |
| Carbon, BrokenArXiv di settembre | 82,39% | 18,60 dollari |
| GPT-6.1 Sol, BrokenArXiv di settembre | 82,70% | — |
| Carbon, ArXivLean di settembre | 62,26% | 45,11 dollari |
| GPT-6.1 Sol, ArXivLean di settembre | 35,85% | 1,16 dollari |
BrokenArXiv propone affermazioni plausibili tratte da congetture e altre affermazioni che lavori recenti hanno confutato; il modello deve valutare una proposizione senza sapere in anticipo che è falsa. Il punteggio premia il riconoscimento della falsità e assegna zero se il modello afferma di aver dimostrato una proposizione falsa. In questo contesto, il risultato di ottobre non misura soltanto la capacità di produrre una dimostrazione: mette anche alla prova la capacità del modello di individuare una premessa errata.
ArXivLean valuta dimostrazioni formali. Nella sessione di settembre, Carbon ha raggiunto il 62,26% contro il 35,85% di Sol. Questo divario, molto più ampio di quello registrato in BrokenArXiv a ottobre, può rendere Carbon più interessante per attività di questo tipo, anche se il costo registrato è stato di 45,11 dollari per problema contro 1,16 dollari per Sol.
Più risposte, più spesa
Il costo non dipende soltanto dal prezzo base di output. Nella configurazione registrata per Carbon e Sol, entrambi i modelli hanno lo stesso prezzo di output: 10 dollari per milione di token. Tuttavia, in BrokenArXiv di ottobre Carbon ha generato in media 563.757 token di output per tentativo, contro gli 89.623 di Sol. La differenza nei volumi aiuta a spiegare perché la spesa per problema sia così diversa.
I dati delle prove di Carbon indicano inoltre un uso intensivo dell’output. In ArXivLean di settembre, MathArena registra 1.064.444 token generati e un costo di 45,11 dollari per problema. In BrokenArXiv, i tentativi di ottobre hanno registrato una media di 563.757 token e 18,06 dollari. I costi non sono intercambiabili: dipendono dal set valutato e dal lavoro svolto in ciascun tentativo.
Questo cambia la valutazione pratica per i team che confrontano i modelli. Se l’obiettivo è massimizzare la percentuale di risposte corrette in un’attività matematica impegnativa, pagare di più per Carbon può avere senso; se il volume di richieste è elevato e Sol raggiunge un risultato sufficiente, il suo costo inferiore per tentativo pesa molto. Il confronto rilevante non è solo «quale modello si classifica al primo posto», ma quanto costa raggiungere il livello di prestazioni richiesto da una specifica applicazione.
Un leader che non sempre finisce in tempo
Alle prestazioni superiori si accompagna un limite operativo. The Decoder segnala che il tipo di errore più comune di Carbon in MathArena è superare il tempo disponibile. Indica inoltre che il modello abbandona raramente un’attività: questa perseveranza può essere utile quando il problema richiede esplorazione, ma può consumare risorse senza produrre una soluzione in tempo.
In un caso, Carbon ha avviato uno script che ha continuato a funzionare per oltre undici ore senza verificarne i progressi. L’esempio non consente di calcolare la frequenza di questo comportamento, ma illustra il tipo di costo che un punteggio medio non rileva: oltre alla fatturazione dei token, un’esecuzione prolungata può occupare capacità e lasciare un’attività irrisolta entro i tempi previsti.
Per gli sviluppatori, la conseguenza è che un benchmark di ragionamento e una valutazione di prodotto rispondono a domande diverse. MathArena misura le prestazioni su problemi matematici secondo il proprio protocollo; l’esperienza di un’applicazione dipende anche dalla capacità del modello di terminare entro il tempo consentito e dalla sostenibilità del costo per tentativo.
Scegliere in base all’attività, non alla medaglia
Il confronto tra i primi tre modelli illustra il compromesso. Carbon ottiene il miglior risultato complessivo e supera Sol in BrokenArXiv di ottobre, ma a settembre Sol è in vantaggio. Fable 5.2 si colloca al secondo posto nella classifica aggregata, anche se il costo stimato di 40,20 dollari per problema lo rende ancora più caro di Carbon; in BrokenArXiv di ottobre registra il 73,46% e 39,78 dollari.
MathArena pubblica anche i risultati per sessione e consente di esaminare le tracce delle risposte. Per un’azienda che sta valutando questi modelli, questo livello di dettaglio è più utile che trasferire direttamente la classifica in produzione: un’attività simile ad ArXivLean porta a una conclusione diversa da una valutazione incentrata su BrokenArXiv, e la stima complessiva non sostituisce la misurazione dei costi sul set di problemi che si intende utilizzare.
La notizia, quindi, non è semplicemente che Google abbia scalzato OpenAI dal primo posto. È che Carbon ottiene un vantaggio stimato e specifico in matematica in cambio di più token, costi maggiori e il rischio di superare il tempo di esecuzione. La domanda per ogni team è quanto valga questo miglioramento nel proprio carico di lavoro effettivo e se sia in grado di sostenere il costo dei tentativi che non terminano in tempo.
Fonti: The Decoder, MathArena, MathArena, AI Ping