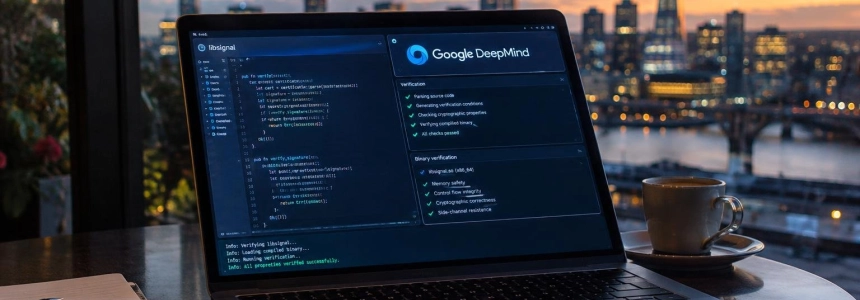
Sono bastate quattro settimane a Google DeepMind per applicare AlphaProof Code alle proprietà di sicurezza del codice di libsignal, l’implementazione di riferimento del protocollo Signal. Il risultato va oltre la verifica di un progetto crittografico astratto: le dimostrazioni riguardano il binario compilato per AArch64. La differenza è importante perché una specifica corretta non garantisce, da sola, che il programma distribuito sui dispositivi mantenga le stesse proprietà.
Il lavoro non dimostra che l’intera applicazione Signal sia priva di difetti, né copre ogni componente del protocollo. Si concentra su proprietà chiave del suo nucleo crittografico e su una versione specifica compilata per l’analisi. Il suo interesse risiede tanto nell’ambito quanto nel metodo: un sistema di agenti IA ha generato milioni di righe di prove formali, mentre le decisioni che determinano il significato di «sicuro» sono rimaste soggette alla revisione umana.
Dal modello del protocollo all’eseguibile
La verifica formale esprime le proprietà di un programma mediante specifiche matematiche e dimostra che il codice le soddisfa. In questo caso, il team ha analizzato libsignal, l’implementazione di riferimento del protocollo Signal. Il lavoro di Google DeepMind ha riguardato il protocollo di instaurazione della sessione PQXDH e Triple Ratchet, con proprietà come la segretezza in avanti, la sicurezza dopo una compromissione e la segretezza dello scambio iniziale. L’articolo tecnico distingue inoltre tra modello simbolico e computazionale, due modi di ragionare sulle garanzie crittografiche.
Il passo avanti rispetto a gran parte delle verifiche precedenti riguarda il livello esaminato. Secondo i ricercatori, gli sforzi precedenti si erano concentrati su modelli astratti, reimplementazioni adattate alla verifica o proprietà più circoscritte. AlphaProof Code, invece, ha collegato le garanzie del protocollo al codice libsignal non modificato, compilato con il compilatore Rust standard in codice macchina AArch64. Il team descrive il risultato come le prime dimostrazioni delle proprietà di sicurezza di un protocollo per un’implementazione ampiamente distribuita e non modificata.
Il processo combina quattro elementi: persone e agenti redigono e revisionano la specifica Lean; il codice Rust viene compilato in un eseguibile; Lean rappresenta la semantica del codice macchina; e gli agenti dimostratori tentano di provare i teoremi concordati. Un componente di controllo accetta una dimostrazione solo se il kernel di Lean la verifica e conferma che si riferisce alla specifica approvata.
flowchart TD
A["Expertos y agentes redactan la especificación"] --> B["Revisión y aprobación humana"]
B --> C["Rust se compila a AArch64"]
C --> D["Lean representa el ejecutable"]
D --> E["Agentes generan pruebas"]
E --> F["Kernel de Lean comprueba la prueba"]
B --> G["Supuestos y contratos revisados"]
G --> F
La portata del risultato è notevole: l’articolo tecnico conta circa 6,5 milioni di righe Lean generate dagli agenti. Questo volume, però, non equivale a milioni di righe che una persona deve accettare sulla fiducia. Lean verifica le dimostrazioni con il proprio kernel; se una dimostrazione contiene un errore logico, non dovrebbe superare questo controllo. La pubblicazione di Google DeepMind riassume il risultato come oltre sei milioni di righe e afferma che gli agenti hanno sottoposto alla revisione umana solo l’uno per cento del codice esaminato.
La specifica resta il punto critico
Il verificatore può confermare che un’implementazione soddisfa un teorema; non può stabilire se quel teorema esprima la garanzia di cui un’organizzazione ha davvero bisogno. La specifica definisce le proprietà, le condizioni di input e le ipotesi sull’ambiente. Un’ipotesi troppo restrittiva o una proprietà formulata in modo troppo debole può consentire al codice di «dimostrare» qualcosa di insufficiente. Google DeepMind riconosce che elaborare e convalidare la specifica richiede competenze, iterazioni e revisioni.
Nel caso di Signal, gli agenti hanno contribuito ad adattare modelli formali esistenti, ma non è bastato trasferirli alla lettera: i modelli precedenti trattavano separatamente lo scambio iniziale e il ratchet e non includevano il ratchet post-quantistico distribuito. Il team ha dovuto comporre e ampliare queste specifiche con la guida umana. Gli agenti revisori hanno cercato punti deboli e i ricercatori hanno verificato che le ipotesi fossero soddisfacibili e che i teoremi valessero in esecuzioni concrete, per ridurre il rischio di una dimostrazione vacua.
Conta anche ciò che rientra nella base di fiducia. Il lavoro formalizza una semantica di AArch64 e fa sì che Lean verifichi che i byte rappresentati corrispondano all’eseguibile, ma i ricercatori spiegano di non poter dimostrare che l’hardware e il sistema operativo reali si comportino esattamente secondo quella semantica. Inoltre, l’analisi dipende da contratti per alcune routine esterne e da ipotesi sulle primitive crittografiche. La dimostrazione è rigorosa entro questi limiti; non li elimina.
In questo senso, le dimostrazioni prodotte dagli agenti sono meno delicate delle affermazioni che viene chiesto loro di provare. Lean può rifiutare una dimostrazione difettosa, ma non rileva da solo una specifica che ometta una minaccia rilevante o faccia troppe assunzioni sull’ambiente. Questa divisione dei compiti spiega perché il sistema non renda la verifica un’attività interamente autonoma: automatizza la ricerca delle dimostrazioni, non la responsabilità di definire l’obiettivo.
Cosa rivelano i bug reintrodotti
Per verificare che il metodo fosse in grado di distinguere il codice corretto da quello vulnerabile, il team ha reintrodotto due bug precedentemente corretti in versioni isolate di libsignal. AlphaProof Code ha dimostrato che le varianti difettose non soddisfacevano i teoremi di sicurezza. WIRED riferisce inoltre che l’analisi del codice attuale non ha trovato nuove vulnerabilità nelle parti esaminate. Il risultato convalida la capacità del processo di rilevare quei bug noti, ma non permette di concludere che verrà individuato qualsiasi errore, in qualunque parte dell’applicazione.
L’ambito preciso è una distinzione decisiva per le aziende che vogliono interpretare queste dimostrazioni. Non è stata verificata l’intera applicazione mobile di Signal né la totalità dei suoi componenti; è stato esaminato il nucleo crittografico definito dal progetto, con un eseguibile collegato a un piccolo programma di test. La dimostrazione non diventa neppure una garanzia universale contro gli attacchi: le proprietà verificate e i modelli utilizzati definiscono quali attacchi sono esclusi, date le ipotesi dichiarate.
“We are very excited by this result, but there is a long distance to go before we are able to scale this to all the software of the world, and we want to do that,”
— Swarat Chaudhuri, ricercatore di Google DeepMind
La cautela è opportuna anche per quanto riguarda i tempi. Il progetto è durato quattro settimane, rispetto agli anni di lavoro specialistico che, secondo DeepMind, sarebbero stati necessari per una verifica di questa complessità con i metodi precedenti. WIRED segnala però che il team è partito da un lavoro di verifica formale già svolto da Signal. Non si tratta di una misurazione del costo di applicare il sistema da zero a un prodotto qualsiasi: Google DeepMind ha condotto questa analisi come progetto di ricerca gratuito e non ne ha rivelato il costo. Google non ha nemmeno commentato se intenda offrire un prodotto o un servizio commerciale di verifica formale.
L’opportunità — e il conto ancora da pagare — per le aziende
Per i team che gestiscono software critico, il potenziale cambiamento riguarda il costo di produrre dimostrazioni approfondite su codice già esistente. L’articolo tecnico ricorda che i precedenti progetti di verifica formale di sistemi importanti hanno richiesto anni-persona: cita venti anni per il microkernel seL4 e sei per il compilatore CompCert. Inoltre, quei sistemi erano stati scritti tenendo conto della verifica. libsignal rappresenta una sfida diversa: analizzare codice di produzione preesistente, compilato senza modifiche, e verificare le proprietà fino all’eseguibile.
La riduzione dei tempi potrebbe ampliare la gamma di componenti per cui vale la pena investire nella verifica formale, invece di riservarla soltanto ai sistemi progettati fin dall’inizio attorno a dimostrazioni matematiche. Google DeepMind propone di estendere l’approccio al firmware dei dispositivi medici e al software delle reti elettriche, e cita la possibilità di combinarlo con sistemi come CodeMender. Per un’azienda, si apre così una strada da valutare; non è ancora dimostrato che il processo sia accessibile o riproducibile su qualsiasi base di codice.
Questo è il principale compromesso: meno lavoro manuale per costruire le dimostrazioni, in cambio di un investimento costante nelle specifiche, nella revisione delle ipotesi e nella comprensione dell’ambiente di esecuzione. I milioni di righe generate riducono il carico di scrittura delle dimostrazioni, ma non sostituiscono gli specialisti in grado di decidere se le proprietà siano adeguate, né i responsabili che delimitano i componenti esterni considerati affidabili. Il fatto che una parte del codice richieda una revisione umana non significa nemmeno che il 99% del sistema sia rimasto del tutto privo di supervisione: significa che, secondo DeepMind, gli agenti hanno concentrato la revisione manuale su una frazione del codice analizzato.
Google DeepMind ha pubblicato le specifiche e le dimostrazioni affinché altri possano esaminarle e riutilizzarle. La pubblicazione consente di studiare il metodo e le sue scelte formali; la prossima sfida pratica sarà capire quanto di questo lavoro possa essere trasferito ad altri sistemi e a quale costo. Nel caso di Signal, la dimostrazione raggiunge il codice crittografico compilato, ma non l’intera applicazione che lo circonda.
Fonti: The Decoder, Google DeepMind, ricercatori di Google DeepMind, WIRED