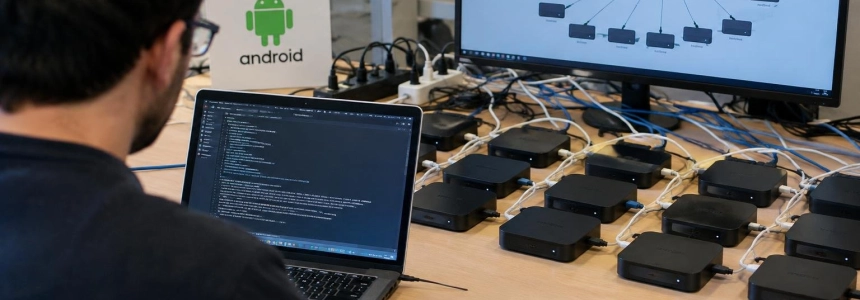
Quindici decoder Android di marca sconosciuta sono bastati perché Anthropic eseguisse un modello da 26 miliardi di parametri senza ricorrere a un centro dati. Il cluster ha raggiunto 0,39 token al secondo: troppo lento per una normale conversazione, ma sufficiente a dimostrare che dispositivi economici connessi a internet possono fornire capacità di calcolo distribuita.
L’esperimento fa parte di una ricerca del Frontier Red Team di Anthropic, pubblicata il 12 ottobre da William Zhou e Daniel Freeman. Il team ha esaminato uno scenario più inquietante della semplice esecuzione locale: se un modello piccolo potrebbe essere installato su dispositivi compromessi e continuare a propagarsi autonomamente. La conclusione non è che questa minaccia esista già, ma che alcuni elementi tecnici potrebbero essere più vicini a combaciare.
L’ostacolo non è solo entrare in un altro dispositivo
Anthropic ha suddiviso la replicazione autonoma in quattro fasi: individuare gli obiettivi, ottenere l’accesso, avviare l’inferenza e proseguire dal nuovo dispositivo. La ricerca si è concentrata soprattutto sulla terza. I ricercatori hanno in gran parte tralasciato le prime due, perché lavori precedenti avevano già mostrato capacità di sfruttamento nei modelli piccoli e perché volevano misurare il problema di eseguire un modello su hardware sconosciuto.
Per il test delle prestazioni, il team ha distribuito Gemma4-26B-A4B su 15 decoder Android economici, acquistati a circa 55 dollari ciascuno, secondo Anthropic. Ogni dispositivo ospitava due livelli del modello. Il risultato, 0,39 token al secondo, mostra un uso molto diverso da quello di un chatbot interattivo: un’attività automatizzata potrebbe tollerare una velocità ridotta se nessuno è in attesa di una risposta.
In un’altra valutazione, Qwen3.5-9B ha funzionato su 8 di 9 tipi di hardware durante la configurazione di un server di inferenza. I test hanno incluso dispositivi diversi, da Jetson Nano a Mac e schede RTX 4090. Il lavoro di installazione — scegliere strumenti compatibili, risolvere le dipendenze e correggere i problemi specifici di ciascuna macchina — è stato proprio uno degli aspetti più impegnativi.
Un test di propagazione in condizioni favorevoli
Anthropic ha inoltre testato una sequenza completa in una rete isolata di Google Cloud, composta da otto nodi con emulatori Android. Il modello doveva individuare altri nodi, connettersi, trasferire un payload e avviare lì un server di inferenza. Quando il server superava i controlli del team, su quel nodo veniva avviata un’altra copia del processo.
GLM-5.2 ha raggiunto tutti e otto i nodi in quattro tentativi su cinque e sette nodi nel tentativo restante. La dimostrazione aveva però un limite fondamentale: l’accesso era stato semplificato tramite una porta Android Debug Bridge non autenticata. Inoltre, GLM-5.2 veniva eseguito su un server separato; i nodi installavano Llama3.1-8B, il modello che potevano ospitare in quelle condizioni. Anthropic presenta il risultato come una valutazione semplificata, non come un’infezione autonoma su internet.
La differenza tra capacità e dimensioni resta decisiva. GLM-5.2 è riuscito a completare la sequenza di test, ma è troppo grande per i decoder presi in esame. I modelli più piccoli possono installare l’inferenza su hardware diversi, ma non riescono ancora a combinare in modo affidabile tutti i passaggi. Anthropic stima che, se il progresso storico continuerà, i modelli piccoli potrebbero raggiungere prima della fine del 2026 il livello di capacità osservato in GLM-5.2. La stessa azienda definisce approssimativa questa proiezione; non dimostra che un replicatore pratico comparirà entro quella data.
The New Stack aggiunge che consentire agli agenti di riutilizzare gli appunti dei tentativi precedenti ha migliorato il successo di Qwen3.5-9B nelle attività di installazione. Al contrario, fornire accesso a Opus 4.8 come consulente non ha prodotto miglioramenti misurabili: il modello piccolo non sapeva sempre quali domande porgli. L’assistenza di un altro modello, quindi, non ha risolto da sola gli errori di esecuzione.
Cosa comporterebbe una botnet di decoder
Anthropic ha usato come riferimento Kimwolf, una botnet che ha infettato oltre due milioni di dispositivi, principalmente decoder Android di marche poco conosciute. Se quel numero fosse suddiviso in gruppi di 15 come quello dell’esperimento, il calcolo darebbe circa 133.000 copie del modello e 80.000 token al secondo complessivi, una capacità paragonabile a circa 40 GPU Nvidia H100, secondo la stima riportata da The New Stack. Non è una rete che Anthropic abbia realizzato: è una proiezione basata sulle dimensioni di Kimwolf e sul test di laboratorio.
L’installazione di ogni copia potrebbe richiedere da 28 a 150 ore, a seconda del modello, secondo The New Stack. Per Anthropic, una propagazione lenta non elimina il rischio se il processo può avanzare senza supervisione e sfruttare risorse appartenenti a terzi. I ricercatori sottolineano comunque che il trasferimento di modelli di diversi gigabyte genererebbe traffico rilevabile.
Come misura difensiva, Anthropic propone interventi come isolare dalla rete i dispositivi infetti. The New Stack ricorda che, durante la bonifica di Mirai, la quarantena applicata da un provider ha eliminato il 92% delle infezioni in 14 giorni. Anthropic propone anche di vietare le password predefinite nei dispositivi, seguendo una norma britannica. Resta da verificare se i modelli piccoli riusciranno a combinare capacità sufficiente e dimensioni compatibili in condizioni reali, senza l’accesso semplificato della rete di test.
Fonti: Futuro Prossimo, Anthropic, The New Stack, Yahoo Tech