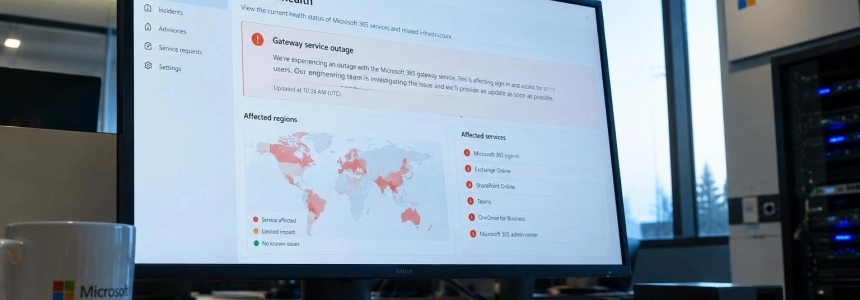
Oltre l’80% dei server di rete interessati ha smesso di rispondere durante l’interruzione globale di Microsoft 365 del 12 e 13 novembre. Microsoft attribuisce l’incidente, durato quasi 24 ore, a un difetto di Windows introdotto a luglio con un aggiornamento per i propri gateway, aggravato da un aumento del carico e da una riduzione temporanea della capacità.
L’impatto maggiore si è concentrato su Exchange Online: molti utenti non riuscivano ad accedere alle proprie caselle di posta e l’invio e la ricezione delle e-mail hanno subito ritardi. Anche Teams, Copilot, SharePoint e OneDrive hanno registrato malfunzionamenti nelle funzioni che dipendono da Exchange. L’interruzione è variata in base alla regione, al momento e al metodo di connessione.
Un difetto latente da luglio
Il rapporto preliminare di Microsoft, datato 15 novembre, indica tre fattori concomitanti. Il primo è stato un difetto introdotto a luglio, durante la distribuzione di un aggiornamento per i server gateway di rete di Microsoft 365. L’azienda afferma che la modifica è stata distribuita gradualmente in tutto il mondo e ha funzionato per oltre tre mesi senza incidenti visibili.
Il guasto si manifestava con determinati carichi. La contesa tra attività per un blocco condiviso all’interno di un processo interno di Windows — un problema noto come contesa dei blocchi — poteva esaurire le risorse di CPU e memoria e bloccare la macchina. L’anomalia era più probabile sull’hardware moderno con più core, ma i test di carico di Microsoft si concentravano su macchine meno potenti e con meno core.
L’aggiornamento era stato preparato appositamente per i server di rete di Microsoft 365. Microsoft ha chiarito che non interessa altre installazioni di Windows. Questa precisazione distingue l’incidente da un difetto generale di Windows Server: il problema era legato al percorso del codice dei gateway di Microsoft 365, non a tutti i server che eseguono Windows.
Il traffico aggiuntivo ha innescato il guasto a cascata
Il secondo fattore è stato un cambiamento nel percorso del traffico. Circa 15 ore prima dell’interruzione, il traffico di Teams è passato automaticamente da un gateway alternativo a quello principale, che serve anche Exchange Online. Microsoft ha descritto il cambiamento come un’operazione normale, ma ha aumentato il carico sull’infrastruttura interessata.
Inoltre, quasi il 14% della capacità dei server gateway era fuori servizio a causa di un problema indipendente verificatosi il giorno precedente. La capacità avrebbe dovuto essere ripristinata tramite attività di routine; separatamente, Microsoft riteneva che il sistema avesse ancora margine sufficiente. L’aumento del carico e la capacità ridotta, combinandosi, hanno portato i server nelle condizioni che attivavano il difetto.
Quando una macchina smetteva di rispondere, i sistemi automatici reindirizzavano le richieste verso i server ancora operativi. Ma questi ricevevano più traffico e potevano bloccarsi a causa dello stesso guasto. In meno di due ore, l’anomalia si era propagata nell’infrastruttura: nel momento peggiore, oltre l’80% dei server non rispondeva.
Le barriere progettate per contenere l’impatto entro singoli componenti o regioni non sono riuscite a impedirne la diffusione su scala globale. Il rapporto preliminare individua un problema separato che ha compromesso queste protezioni, anche se non ne descrive completamente la causa. Anche le differenze tra i servizi hanno influito sulla durata: Teams, OneDrive, SharePoint e le applicazioni di Office potevano uscire dall’infrastruttura difettosa; Exchange Online non poteva farlo per ragioni di scala.
Perché il ripristino è durato così a lungo
Riavviare i server non era sufficiente. Quando tornavano a ricevere il traffico accumulato, alcune macchine si bloccavano di nuovo. I normali processi automatici non erano progettati per ripristinare un’interruzione di tale portata e neppure le consuete opzioni di rollback potevano rimuovere rapidamente una modifica distribuita da mesi.
Microsoft ha individuato nella negoziazione delle connessioni il principale collo di bottiglia tra le 00:30 e le 01:00 UTC del 13 novembre. Alle 07:20 UTC ha applicato una mitigazione: un aggiornamento che riportava il percorso di gestione delle connessioni a uno stato del codice già collaudato. In seguito, i team hanno ritirato i server a gruppi, applicato la modifica, li hanno riavviati e li hanno gradualmente rimessi in servizio.
L’azienda ha anche deviato il traffico su percorsi alternativi, aggiunto capacità e prolungato i tempi di consegna delle e-mail per evitare che i messaggi in coda venissero respinti come non recapitabili. Il ripristino è avanzato per regioni: l’area Asia-Pacifico ha iniziato a riprendersi parzialmente intorno alle 11:00 UTC e l’Europa alle 11:35. La disponibilità globale della posta web è tornata ai livelli previsti alle 14:17.
Microsoft ha dichiarato concluso l’impatto attivo alle 16:10 UTC del 13 novembre, pur continuando a monitorare il servizio e a smaltire la coda di posta. Ha inviato gli ultimi aggiornamenti ai clienti alle 04:15 UTC del giorno 14. Nel rapporto preliminare afferma che i messaggi accumulati sono stati elaborati.
Microsoft esclude un attacco e prepara ulteriori misure
L’azienda ha descritto l’incidente come un guasto tecnico, senza indizi di attività dolose. Ha inoltre negato che l’interruzione fosse collegata ai licenziamenti annunciati il mese precedente o alla sostituzione dei dipendenti con sistemi di IA.
Charles Lamanna, responsabile di Copilot, Agents e Platform in Microsoft, ha riconosciuto la portata del guasto in dichiarazioni diffuse su X.
“In less than two hours, the previously unknown defect was encountered across our fleet and rendered them unresponsive. At its lowest, more than 80% of servers were unresponsive.”
— Charles Lamanna, responsabile di Copilot, Agents e Platform in Microsoft
Microsoft afferma di aver aggiunto capacità, ampliato il monitoraggio del traffico e della gestione delle connessioni e introdotto limiti per ridurre il rischio che una ridistribuzione del traffico provochi un’altra interruzione a cascata. Ha anche esteso i tempi di consegna delle e-mail e confermato che i messaggi in attesa sono stati elaborati.
L’indagine è ancora in corso. Microsoft prevede di pubblicare il rapporto finale il 20 novembre 2026, con l’elenco completo delle misure correttive. Il documento dovrà fornire maggiori dettagli sulle cause e sulle protezioni che non sono riuscite a contenere la propagazione.
Fonti: Wccftech, 9to5Mac, XDA, theregister, The Stack, 365Fanatic